AI 很容易写出一个漂亮的开头,却很难陪作者稳定地完成一部长篇小说。
我最初想的不是“怎样让模型一次生成更多文字”,而是另一个更实际的问题:当创作进入十章、三十章甚至更长的尺度以后,怎样让人物仍然记得自己知道什么,让关系变化有前因,让伏笔按计划推进;作者修改了前文之后,系统又怎样知道哪些后续记忆已经不再可信?
这些问题最终变成了 砚火(InkForge Local):一套面向中文长篇与同人创作的本地 AI 写作工作台。这篇文章按功能拆开讲它能做什么、每一块是怎么做出来的,以及开发过程中几次关键的转折。文中截图来自真实运行的砚火,作品是我为截图临时编的一部示例小说《雾钟》(民国港口悬疑),模型接的是本机一个返回预写内容的模拟接口——证据核验、检索、预检阻断、门禁和并发保护都是砚火本身的真实逻辑。
项目地址:GitHub · InkForge Local · 下载发布版
| 项目 | 现状 |
|---|---|
| 当前版本 | v0.37(源码版本号 0.37.0,最新提交已包含 0.37.1 的开写前设定预检) |
| 技术栈 | FastAPI + Pydantic 2 + HTTPX + SQLite(WAL / FTS5),前端原生 HTML / CSS / JS,无需构建 |
| 代码 | app/ 下 156 个 Python 文件约 4.2 万行,前端 32 个 JS 模块 |
| 测试 | 647 项自动测试全部通过;CI 覆盖 Windows / Linux × Python 3.10 / 3.12 |
| 模型 | 任意 OpenAI 兼容接口:llama.cpp、vLLM、Ollama、DeepSeek、智谱等 |
| 运行方式 | Windows 双击启动器自动准备环境;也有便携版和源码运行 |
一、出发点:要解决的不是“生成”,而是“完成”
把设定和前文发给模型让它续写,在短篇和灵感探索里很好用。但只要尝试把这种方式延伸到长篇,问题就会接连出现:
- 模型记得人物名字,却忘了人物为什么做出某个选择;
- 它读过世界观,却会把未经确认的推测当成事实;
- 它知道上一章发生了什么,却可能让角色提前知道尚未公开的信息;
- 大纲看起来完整,拆成章节后却反复出现同一种冲突;
- 重写了早期章节,旧摘要和旧人物状态仍然继续污染后文;
- 一次长任务超时,前面已经完成的规划也可能全部丢失;
- 自动“精修”看似完成,实际只是生成了新文字,并没有证明问题真正解决。
长篇小说的难点不是字数,而是状态随时间持续变化:人物、关系、地点、伤势、道具、知识、伏笔和读者已知的信息都在变,每一次变化都应该能追溯到具体正文。
所以砚火的核心命题是:
能不能让 AI 参与整部长篇的生产,同时让每一步都能够检查、恢复、修改和追溯?
“砚火”这个名字也来自这里:砚代表承载和秩序,设定、人物状态、证据、历史版本和作者决定都要被稳妥保存;火代表生成和变化,模型的价值在于提出作者没想到的方向。只有火没有砚,生成会越来越失控;只有砚没有火,又会退化成繁琐的资料管理工具。
我给项目定了五条原则,后来的设计几乎都从这里出发:
- 作者拥有最终决定权:AI 输出先成为候选稿,不能静默覆盖已经确认的正文;
- 作品事实必须有来源:模型说过的话不等于故事里已经发生的事;
- 长任务必须可以失败:可靠不是永远不出错,而是出错后知道从哪里继续;
- 本地数据优先:正文、设定、历史和凭据由作者掌握;
- 模型是可替换的能力:作品不能绑定某一家供应商或某一个模型。
二、功能一览
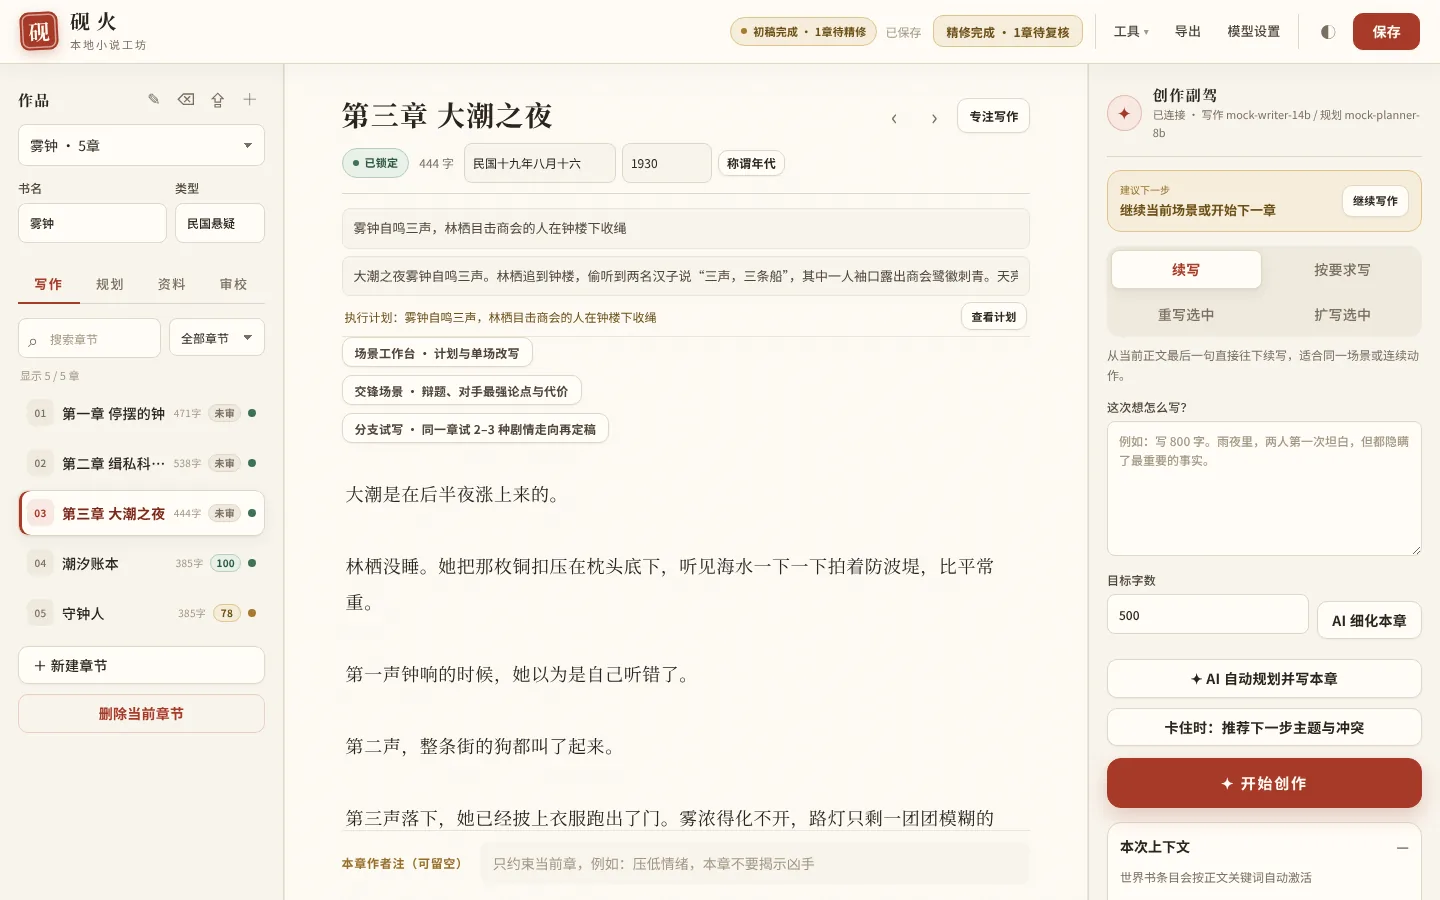
- 写作与候选稿:续写、按要求写、重写选中、扩写选中;结果先进候选区,可以逐项选改、对比原文、审计后再插入;
- 分层规划:灵感孵化 → 故事圣经 → 分卷蓝图 → 逐章路线 → 本章执行计划;8 套题材档案;写完一章自动微调后面几章的路线;
- 人物、世界与资料:人物卡分永久核心和动态状态;世界书按关键词和条件触发;参考资料分文风样文、原作正典、世界背景、研究资料;
- 同人 Canon Lock:原作人格、能力边界、语言模式经人工确认后成为硬约束,接纳正文前检查 OOC;
- 证据记忆:事实、人物知情、关系、时间线、伏笔、道具、伤势,每条都绑定正文原句和正文哈希;修改前文会让后续记忆失效;
- 审校与精修:本地质检 + 五类分项审校,每条问题都回到原句编号核验;修订后只复核上轮问题和改动的句子;
- 开写前设定预检:路线和人物卡、知情边界、年代用语矛盾时,先拦下来再让 AI 连续写;
- 自动导演:从一句灵感到全文,开书、规划、拆章、逐章写作、审校、修订、记忆结算全自动,关掉浏览器也继续跑,可暂停、可恢复;
- 定稿门禁与项目体检:跨章重复段落、高相似章节、记忆待重建,一眼看到;
- 导入与导出:导入旧稿续写,导出 TXT / EPUB / DOCX,GitHub 私人仓库备份;
- 数据安全:版本并发保护、章节快照、凭据加密、自动备份与可回滚的升级。
三、一次完整的创作流程
- 启动:Windows 上双击
InkForgeLauncher.exe(或源码run.bat),浏览器打开127.0.0.1:7860。首次启动有欢迎页和一部演示作品《渡口灯》。 - 配模型:在“模型设置”填 Base URL,点“测试连通”,砚火识别服务类型和能力,再从模型列表里选写作模型;需要的话勾选“规划、审校与记忆提取使用另一个模型”。
- 开书:用“新书向导”选题材和篇幅、写核心构想,或者用“灵感孵化”从一句话生成两套开书方案。
- 规划:打开“AI 分层规划”,依次做全书规划、分卷拆解、批量建章。拆完会自动跑设定预检。
- 写一章:选章节,“AI 细化本章”或“AI 自动规划并写本章”,候选稿在右侧流式出现,“本次上下文”显示命中了哪些世界书条目、记忆和技能。
- 审校:“连续性审计”按风险决定合并审计还是五个分项审校,勾选问题后“AI 修订所选问题”。
- 接纳:“插入并更新记忆”依次锁定正文、分阶段提取记忆、逐字核验证据、提交,状态显示“正文和记忆已可靠提交”。
- 交给导演:“批量建章并让 AI 连续写全书”,后台逐章执行“计划 → 正文 → 审计 → 修订 → 锁定 → 结算”。
- 收尾:看定稿门禁,用“再次精修未通过章节”或“项目体检”处理剩下的问题,最后导出。
下面按模块讲每一步是怎么做的。
四、整体架构
    flowchart TD
  A["一句灵感"] --> B["开书方案与故事圣经"]
  B --> C["人物 · 世界书 · 原作资料"]
  C --> D["全书规划与分卷蓝图"]
  D --> P{"设定预检"}
  P -->|"有严重冲突"| D
  P -->|"通过"| E["逐章路线与场景计划"]
  E --> F["正文候选"]
  F --> G["审校 · 修订 · 复核"]
  G --> H["锁定 · 证据结算"]
  H --> I["长期记忆"]
  I -->|"只取当前章之前的证据"| F
  H --> R["滚动重规划后续 3 章"]
  R --> E
v0.37 把后端按职责分成 11 个包,依赖方向由一组架构测试强制检查:
1 | app/ |
依赖规则是 core ← llm ← story ← storage ← {planning ⇄ writing ⇄ review} ← {director, io, evaluation} ← api。技术选型上,FastAPI 适合大量结构化请求和流式生成;SQLite 不需要用户维护数据库服务,却有事务、索引、FTS5 全文检索和可验证的备份;前端保持原生 JavaScript,让源码、便携版和自动部署版共享同一套静态资源。
五、每一块是怎么做的
模型设置:一个接口,可选两个模型
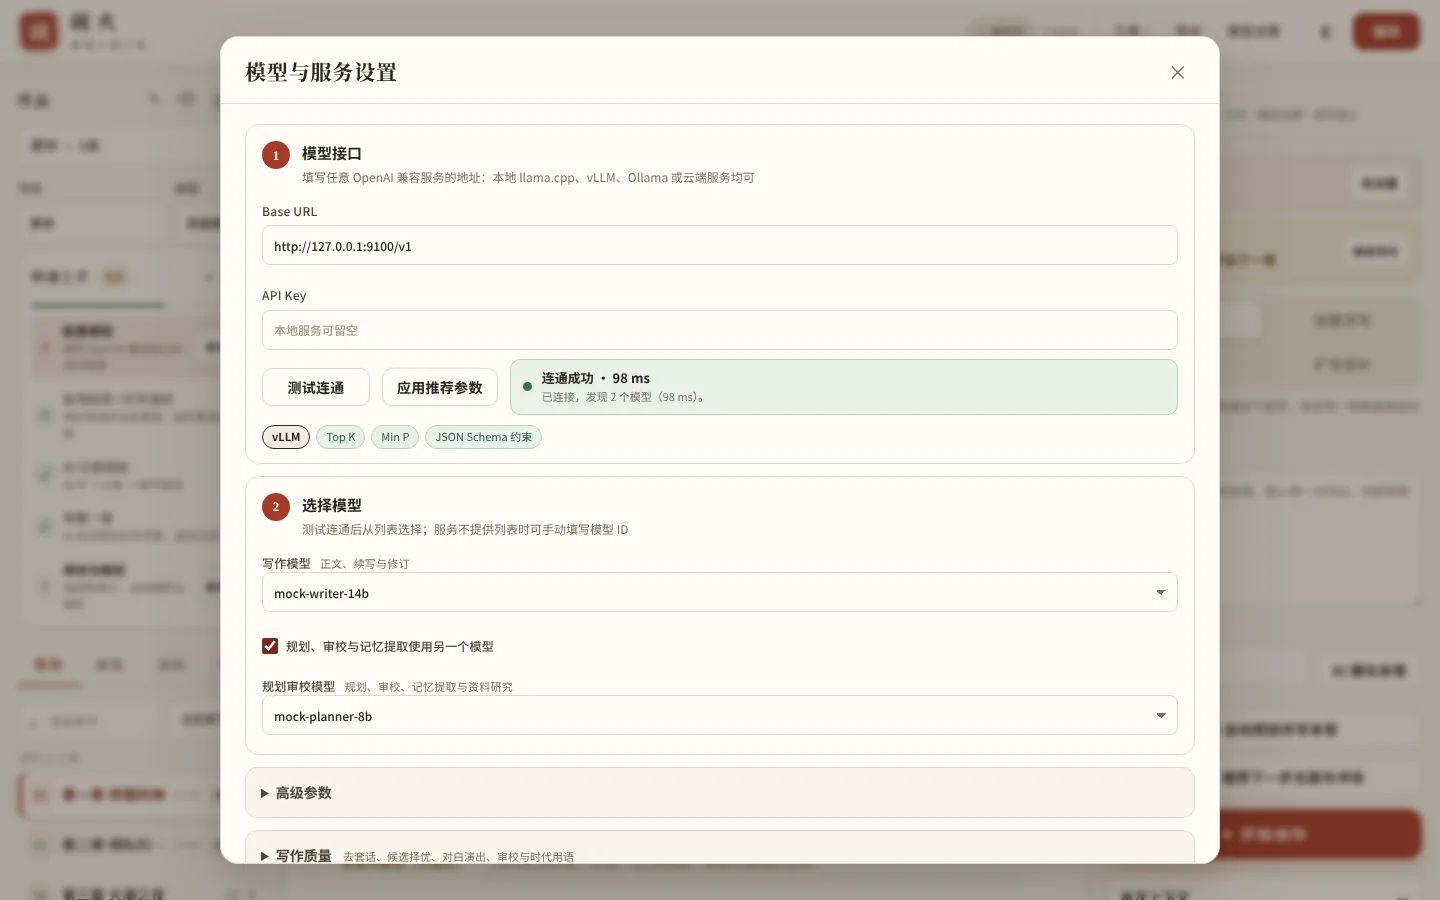
早期界面把“单模型”“双模型”和厂商名称混在一起,用户需要理解内部路由才能完成设置。v0.34 起简化成:
- 只填一个 OpenAI 兼容 Base URL 和可选的 Key;
- “测试连通”读取
/models、测延迟,并识别服务类型——看owned_by(llamacpp / vllm / ollama)、探测/props、看 Server 响应头和主机名; - 选写作模型(正文、续写、修订);勾选另一个选项后,再从同一列表选规划审校模型(规划、审校、记忆提取),留空就用同一个。
识别出的能力决定发哪些扩展参数:Top K、Min P、重复惩罚、cache_prompt、JSON Schema 约束、logit_bias 只发给支持它们的服务,通用服务只收标准参数。0.33 及更早的“模型 1 / 模型 2 + 供应商”配置,在打开作品时自动迁移。Key 不进作品数据——这一点放到数据安全一节讲。
写作与候选稿:AI 只能提议
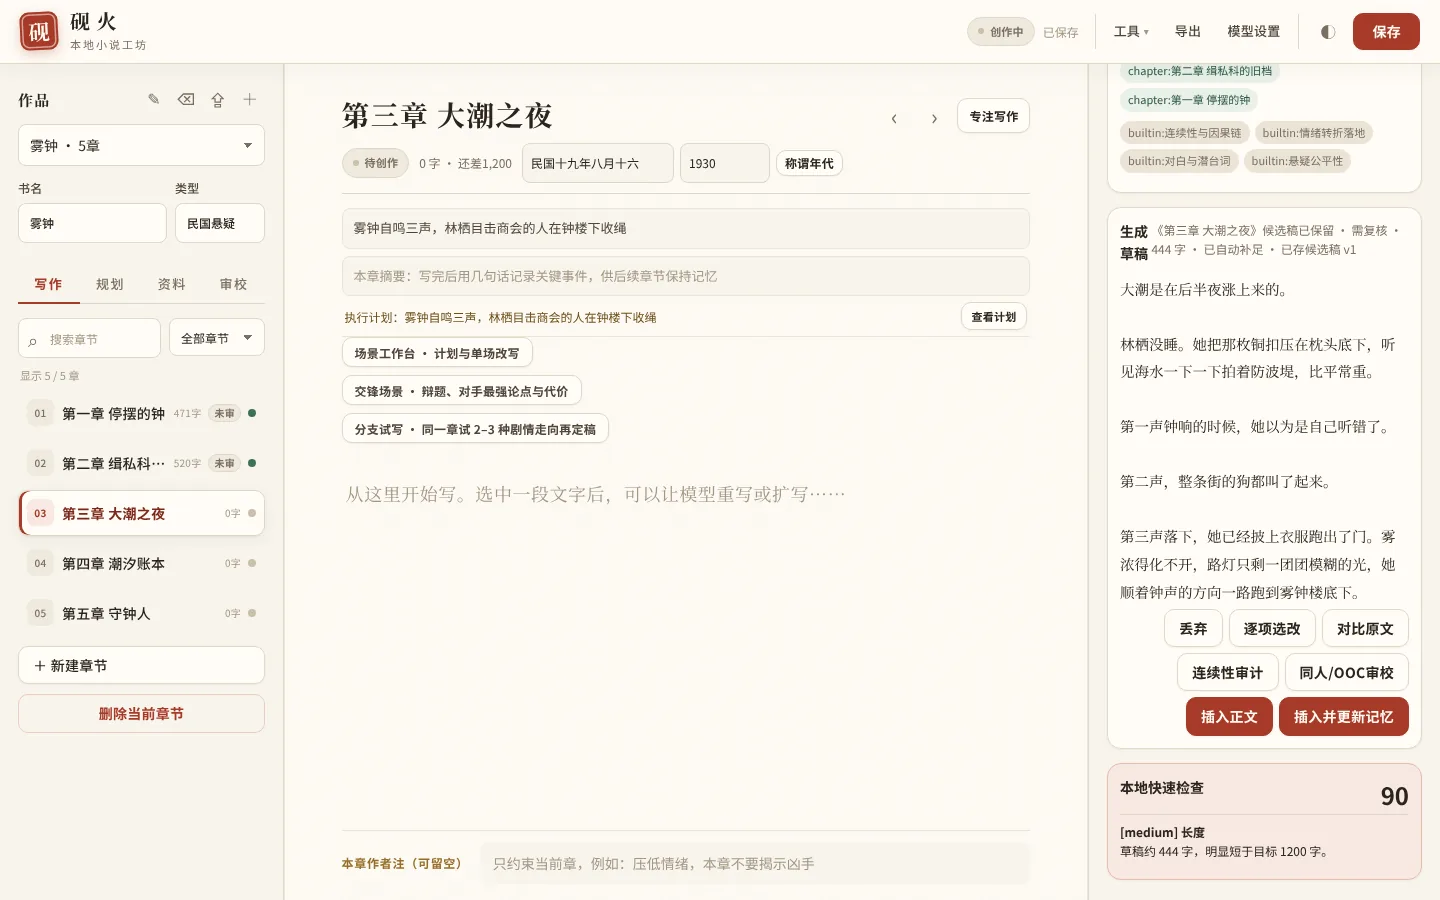
第一阶段我只做了一个最小闭环:创建作品、编辑章节、调用模型生成候选正文、由作者接纳、保存。它验证了三件事:流式输出对写作体验非常重要;候选稿必须和正文分离,否则一次错误生成就可能破坏手稿;续写、重写选区、扩写和新章需要不同的上下文配方。
现在的实现:
- 生成走一个 SSE 流(
POST /api/generate),事件分 token、meta、replace、repair、done; - 上下文由
writing/context_builder.py分层编排:世界书、Canon、知识层、记忆、伏笔欠账、经验提示、技能,再按预算裁剪。为了让前缀缓存命中,system 消息只放每本书逐字节不变的稳定前缀。发送前还会核对完整请求的 token 预算; - 正文过短或被截断时自动续补,界面显示“已自动补足”;
- 草稿记录生成时的正文和选区,生成期间正文被改过就拒绝应用;
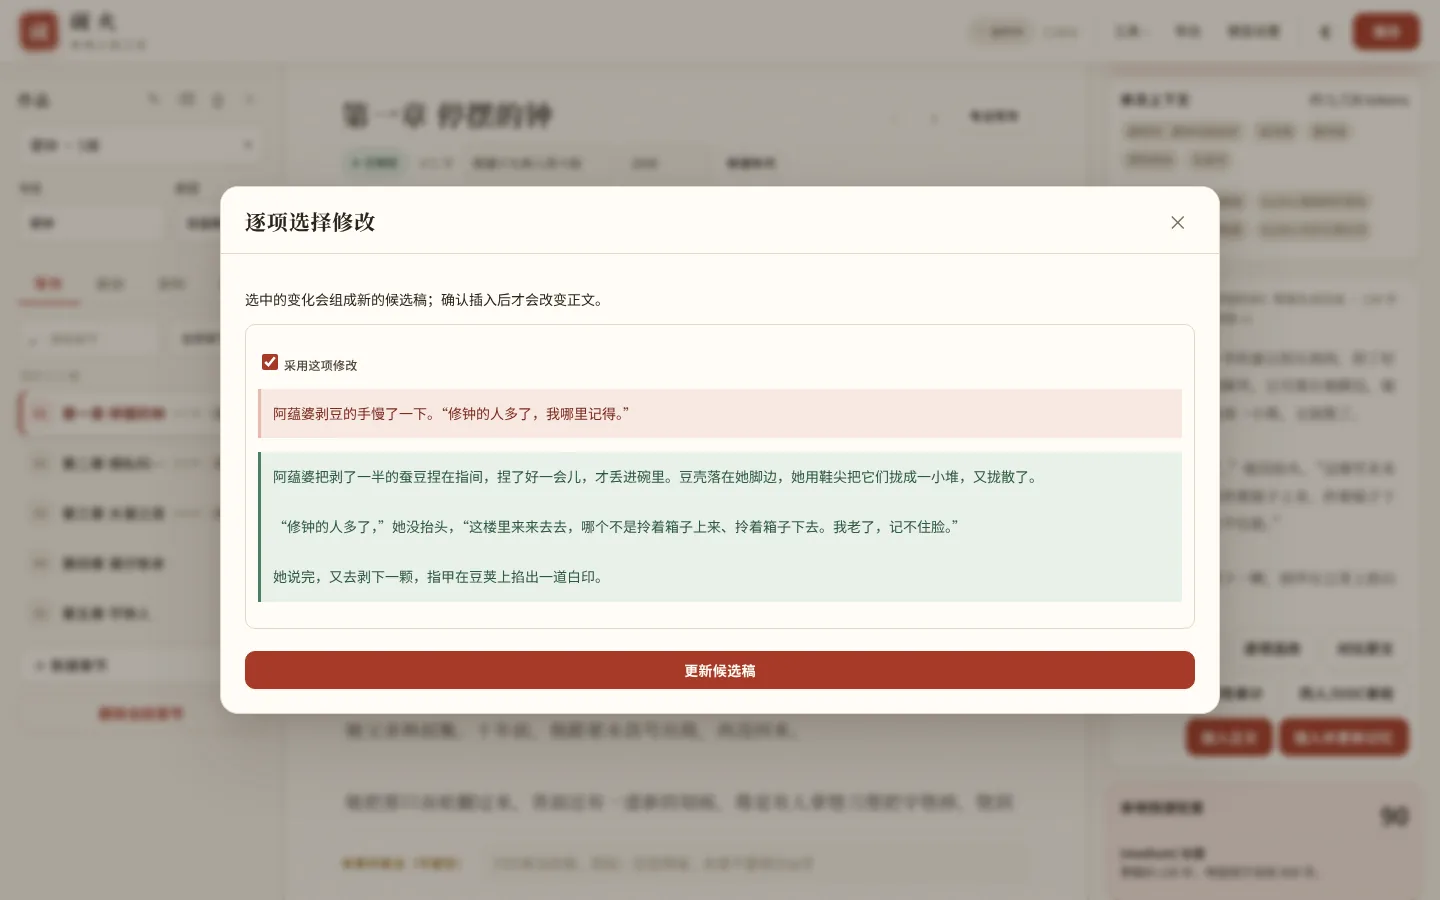
- “逐项选改”按变化片段勾选,组合成新的候选稿。
几个专门针对“AI 味”的设计:
- 去套话(
writing/antislop.py):在 llama.cpp 上先/tokenize再施加负的logit_bias;所有服务在成稿后,只把超额的句子连同前后各一句送去局部改写,从不整章重写。作者禁用的短语零容忍,通用套话和本书自动学到的“疲劳词”每稿各允许一次; - 对白演出(
writing/dialogue_rehearsal.py):这一章有两个以上主要人物时,每个人单独调用一次模型,只给他自己的档案、声纹和截至本章的知情范围;台词和他不该知道的事实共享两个以上四字片段就被拦截; - 关键章多候选:可以一次生成 1~3 版,先做确定性筛查,再让规划模型按 A/B、B/A 两种顺序成对盲评,两次结论一致才算胜出;
- 分支试写:同一章按 2~3 种走向各写一版,审计和盲评后由作者采用,原文存为章节版本。
分层规划:从宏大纲到可执行路线
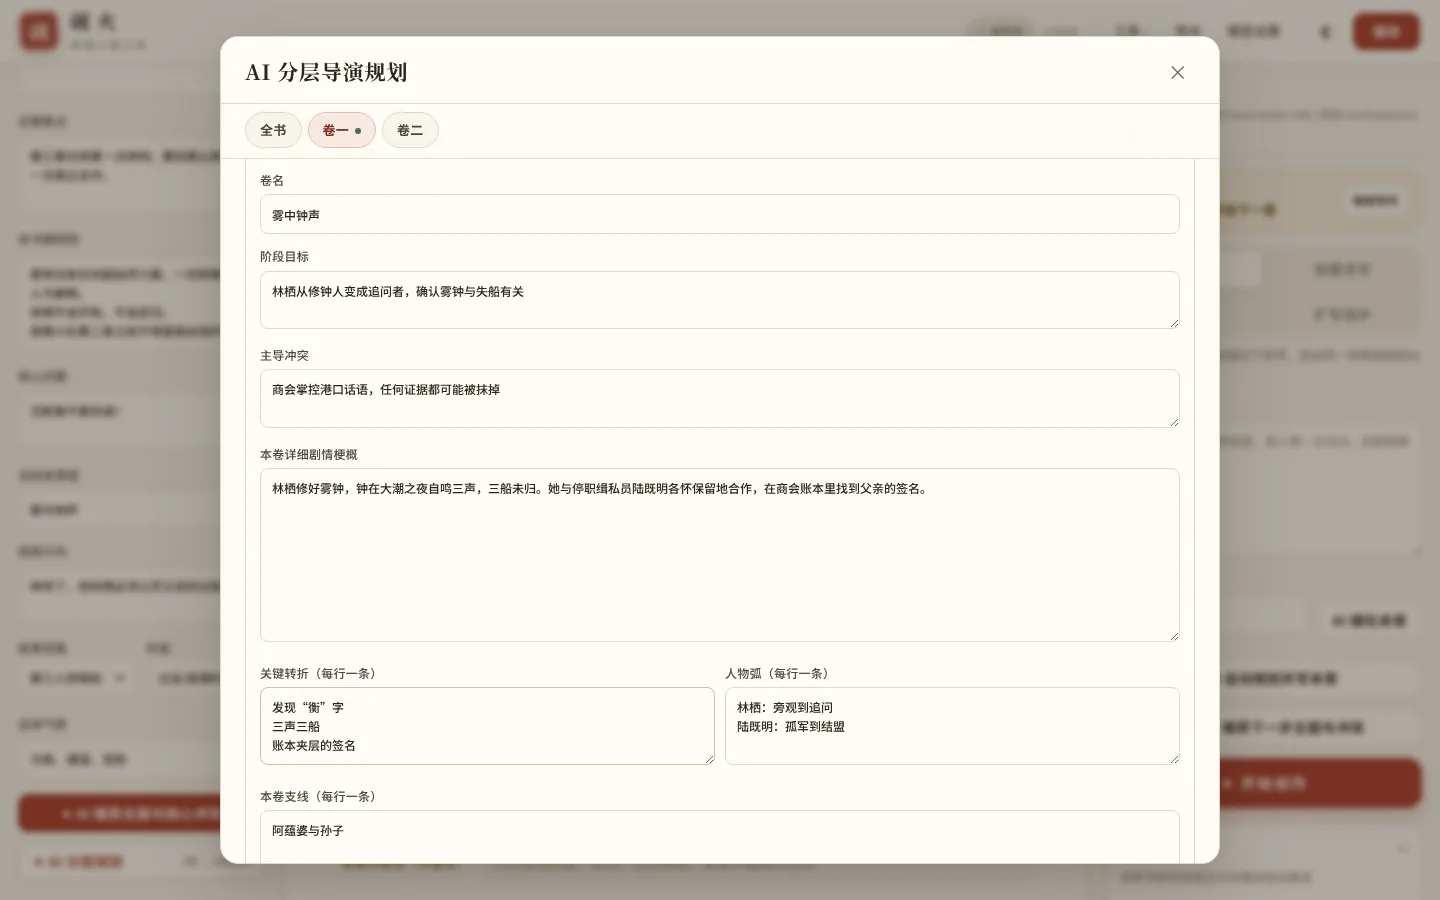
AI 生成大纲的常见问题不是缺少事件,而是事件之间没有不可替代的因果职责:很多章节只是换了地点和角色,实际仍在重复“遇到问题—展示能力—获得认可”。所以规划被拆成几层,每层只解决适合自己的问题:
- 故事圣经:主题、读者承诺、故事发动机、贯穿冲突、终局代价;
- 分卷蓝图:场域、时间跨度、不可逆变化、人物选择、必须保持和必须避免的东西;
- 逐章路线:每章的目标、冲突、转折、章末钩子和故事内日期;
- 本章执行计划:开场第一拍、场景节拍、情绪转折、退出状态。
结构化输出走 llm/structured_output.py:服务支持时用 JSON Schema 约束解码(llama.cpp 的 json_schema,vLLM 等的 response_format),否则用 json_object 加有界修复。批量建章按小批次事务进行,云端模型每批 6 章,每完成一组就立即保存,验证通过再继续。
几个后来加的能力:
- 8 套题材档案(穿越 / 历史、权谋、悬疑、言情、奇幻、科幻、现实、通用),岗位和事件词表按题材生成;叙事策略可选因果与人物、悬疑、关系、冒险、观察或经典十二岗位,十二岗位只是可选方法,不再是硬模板;
- 滚动重规划(
planning/rolling_replan.py):每章结算后,按实际写出的内容微调后面 3 章还没写、没锁定的路线;不跨卷、不改卷契约,校验变差就整体回滚,字段级差异记进历史; - 大纲单独用纯文本写:DeepSeek flash 一类模型在一个 JSON 里要填十几个字段时,详细总纲往往只写 400 字左右。现在先拿到故事圣经,再用一次纯文本调用写“按卷分段、每卷至少 5 个事件”的总纲,保留新旧两版中较长的一版。
人物卡、世界书与资料
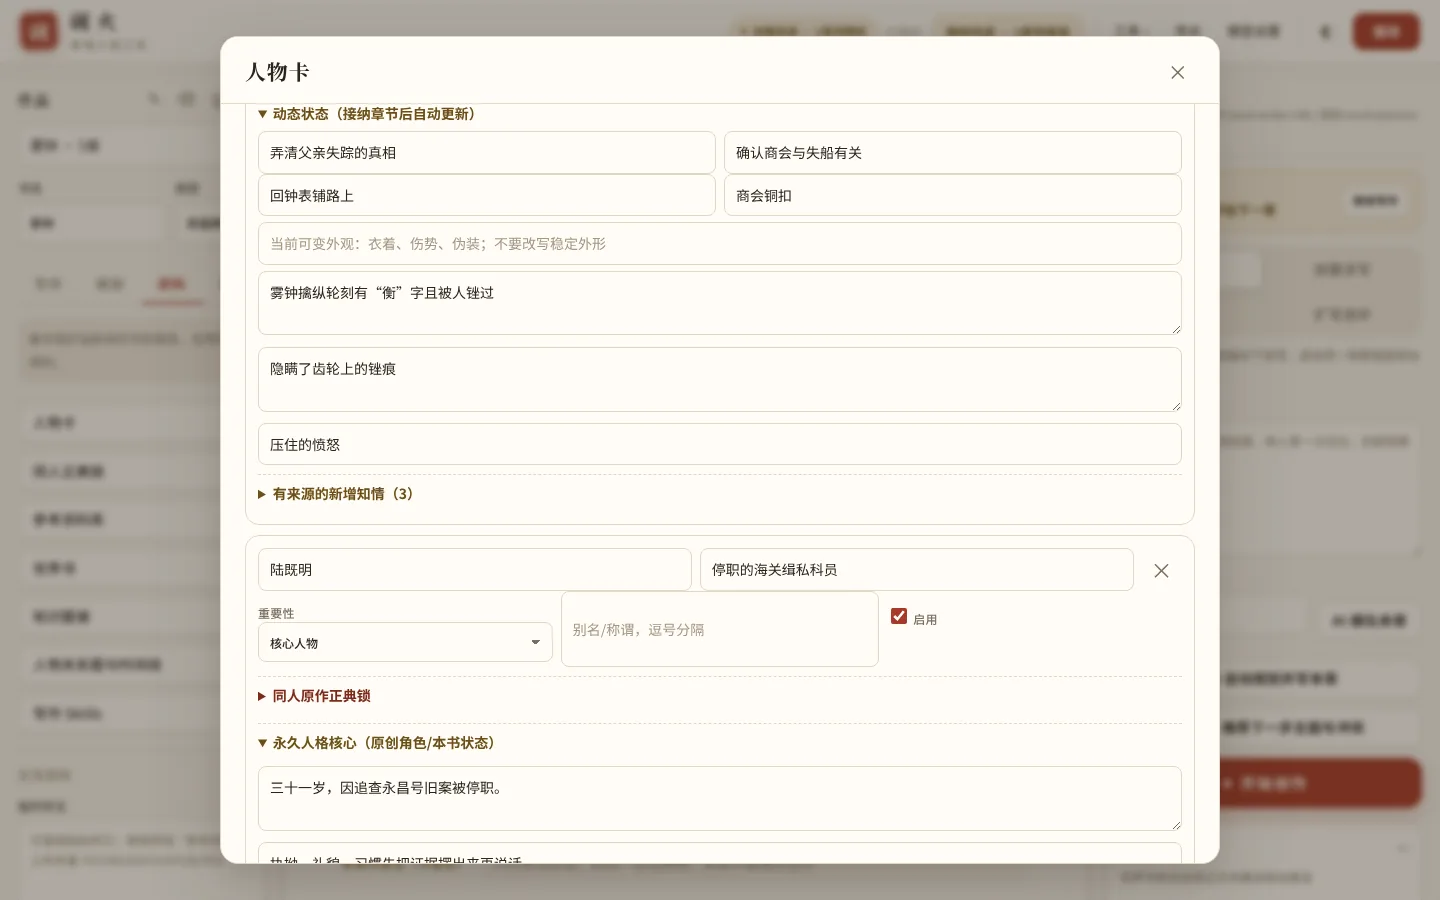
人物卡分两部分:永久人格核心(身份、性格、外貌、价值观、恐惧、矛盾、声音与对白示例、硬限制、生卒年)和动态状态(目标、位置、道具、情绪、可变外观、有来源的新增知情)。动态状态只在接纳章节后由记忆结算更新;临时的衣着写进可变外观,不会覆盖稳定的长相。
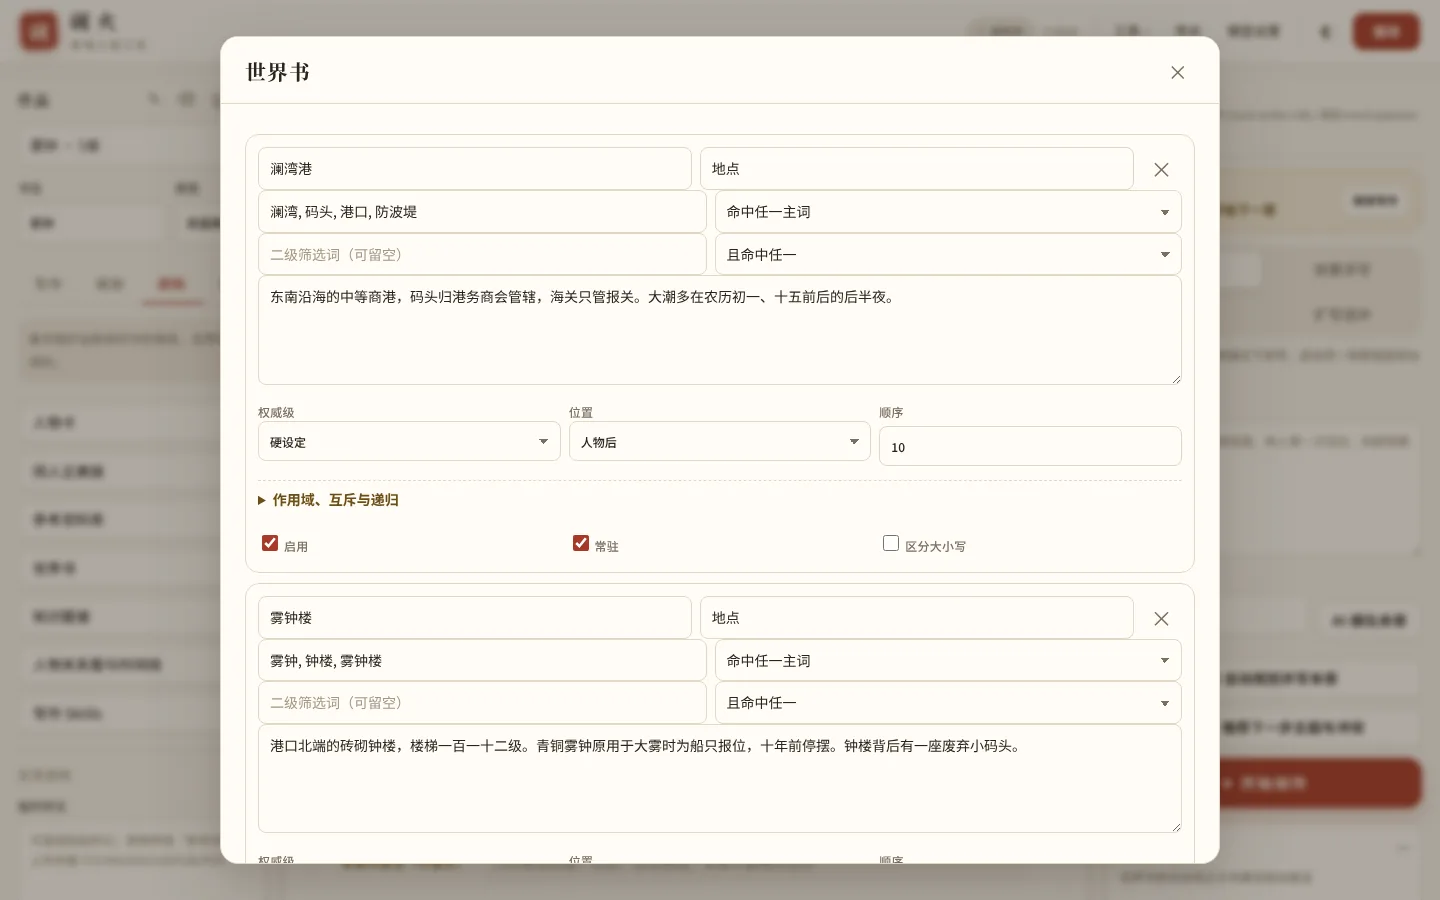
世界书支持关键词和正则触发,逻辑可以组合(任一 / 全部 / 排除),有权威级(权威 / 硬设定 / 软资料)、插入位置、顺序、作用域(章节范围、人物)、互斥组、递归(默认 2 层)和常驻条目,总预算默认 4500 token。这一块参考了 SillyTavern 的 World Info。
参考资料分文风样文、原作正典、世界背景、研究资料四类:文风分析只读样文,正典分析只读原作,避免“学习文风”和“确认事实”互相污染;还会检测和样文的长原句重合,防止复刻。
同人创作还有 Canon Lock:Canon Profile 保存原作、时间节点、人格核心、能力限制、语言 / 行为 / 情绪模式和禁止 OOC 清单。AI 根据资料生成的只是“待核对档案”,人工确认后才成为硬约束;接纳正文前跑 Canon Gate,检查明显 OOC、无铺垫的关系突变和高风险的样文复刻。资料中的事实、模型推断和争议解释分开保存——重要的不是让系统假装自己“懂原作”,而是让它诚实地区分知道、推断和不知道。
证据记忆:整个项目最关键的一次重构
早期版本和很多写作工具一样,靠章节摘要维持上下文。摘要很方便,却有一个根本缺陷:它不断把模型的解释压缩成新的“事实”,原始依据逐渐消失。所以长期记忆后来重构成了带证据的状态系统。
提交是一个状态机:
- 接纳正文:正文先落盘,状态变成“待结算”;
- 分阶段提取:从正文里抽取候选记忆;
- 证据结算:通过就是“已提交”;失败只进入“状态降级”或“隔离”,正文不会丢。
分阶段提取(story/memory_extraction.py)共 6 步,共享同一段正文前缀以利用缓存:核心(摘要、场景结算)、事实(最多 6 条)、人物(最多 4 人,每人最多 2 条知情)、线索(伏笔和时间线各最多 4 条)、关系(最多 4 条)、物件(道具最多 4 条,伤势最多 3 条)。每条都必须带一段 8~30 字的正文连续原句作为证据,本地逐字核验通过才进入权威记忆。输出被截断就减半条目重试;可选阶段失败只告警;“补提取”只重跑失败的阶段。
正文哈希:正文先把换行统一成 \n 再算 SHA-256,每次结算都绑定这个哈希。同一正文重复点结算不会产生重复事实;正文变了,旧的结算结果就不能再提交。
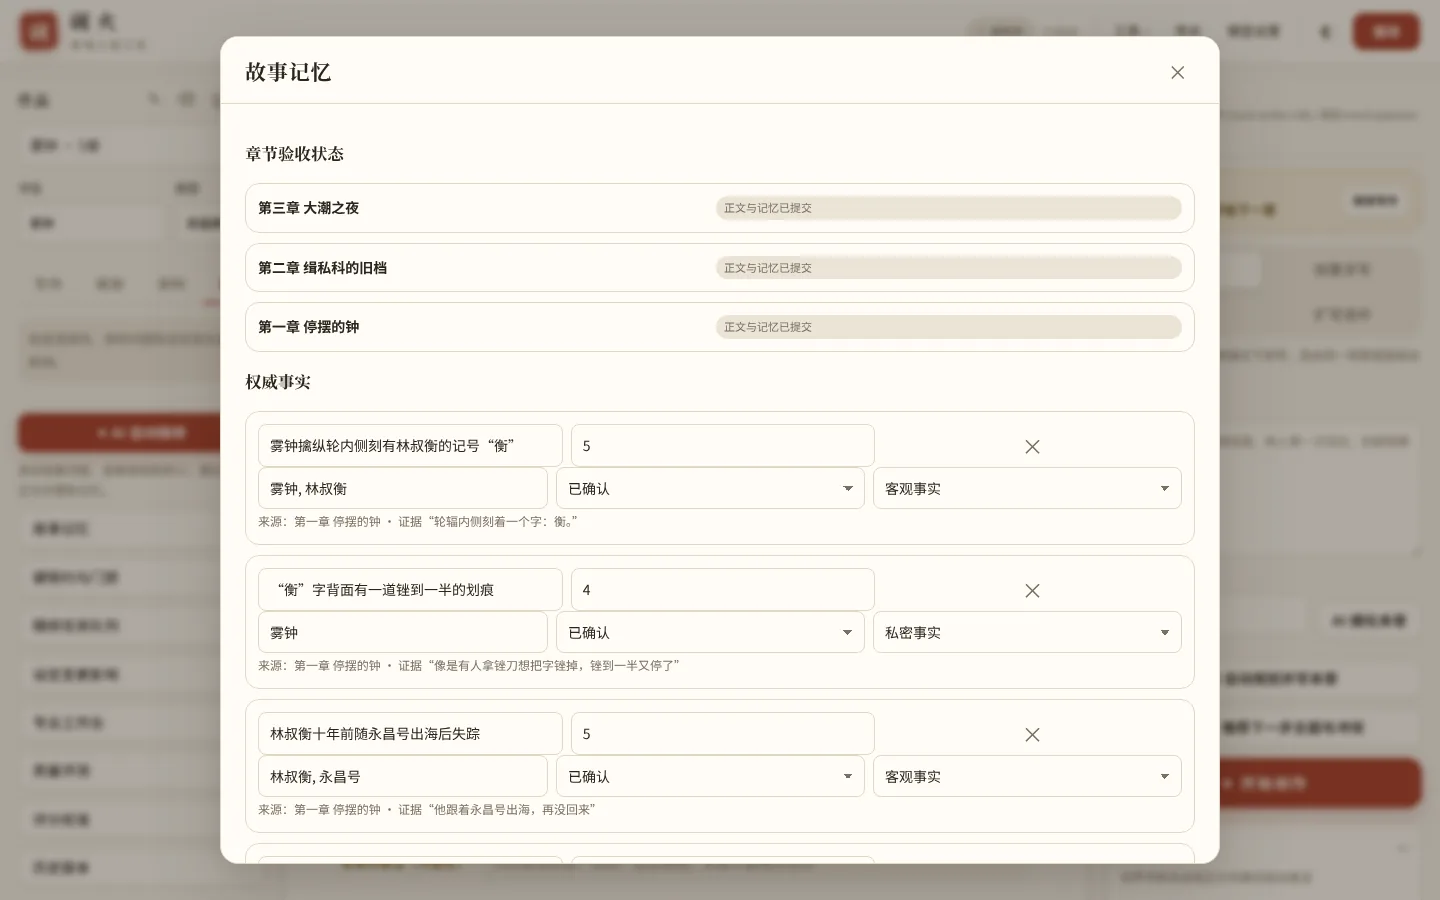
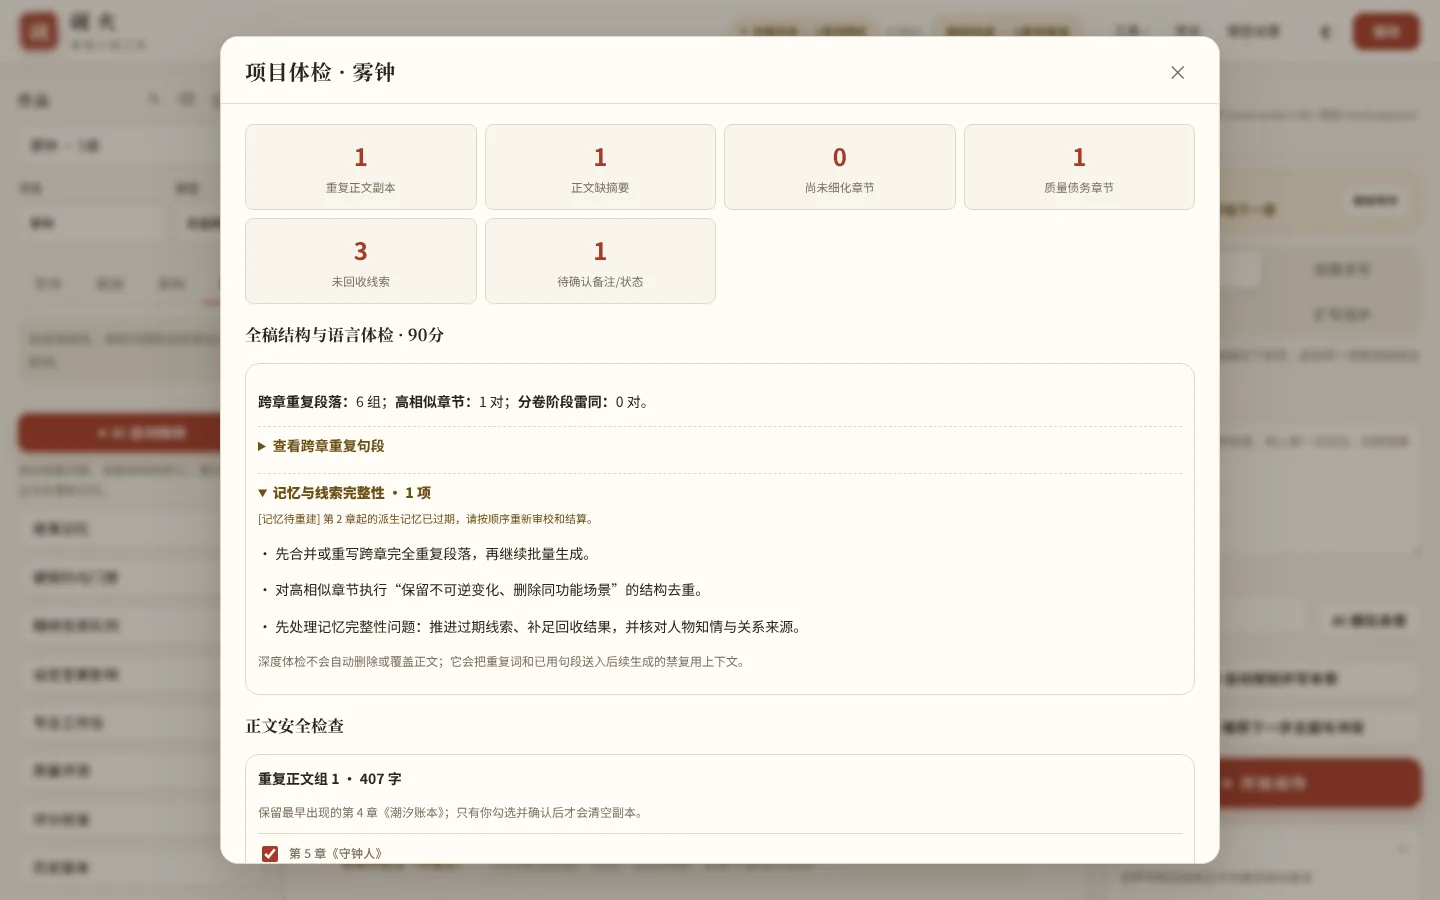
修改前文会让后续记忆失效:改了一个已经结算的章节,系统会标记“从第 N 章起记忆过期”,受影响章节和后文的派生记忆必须按顺序重建。我在截图时直接改了第 2 章正文,“项目体检”里马上出现了“[记忆待重建] 第 2 章起的派生记忆已过期”。
知情编译与时间边界(story/epistemics.py、story/temporal_context.py):作者真相、读者已见的信息、人物有证据的知情分三层编译;生成当前章时只用当前章之前的证据视图,检索在数据库层就排除了当前章和未来章,所以人物不会“提前知道”。
还有几个专门的账本:
- 道具 / 伤势状态机(
story/continuity_state.py):事件按章号记录,任意一章的状态由此前的事件折叠得出,审校时确定性地检查“已遗失的道具被使用”“新伤在最短恢复章数内痊愈”; - 伏笔欠账(
story/hook_ledger.py):接纳章节时记下计划里的章末钩子,按章节 ID 记账(插入或删除章节不会错位),后续审校逐条判定已兑现、已推进、被忽略,超期的变成“钩子债”注入下一章; - 全书摘要不能被一次异常盖掉:模型给的全书摘要只存为候选,“前情提要”由已接纳章节的摘要确定性汇编。
关系图和伏笔时间线都只来自已结算的记忆,可以拖到“截至第 N 章”看当时的状态。
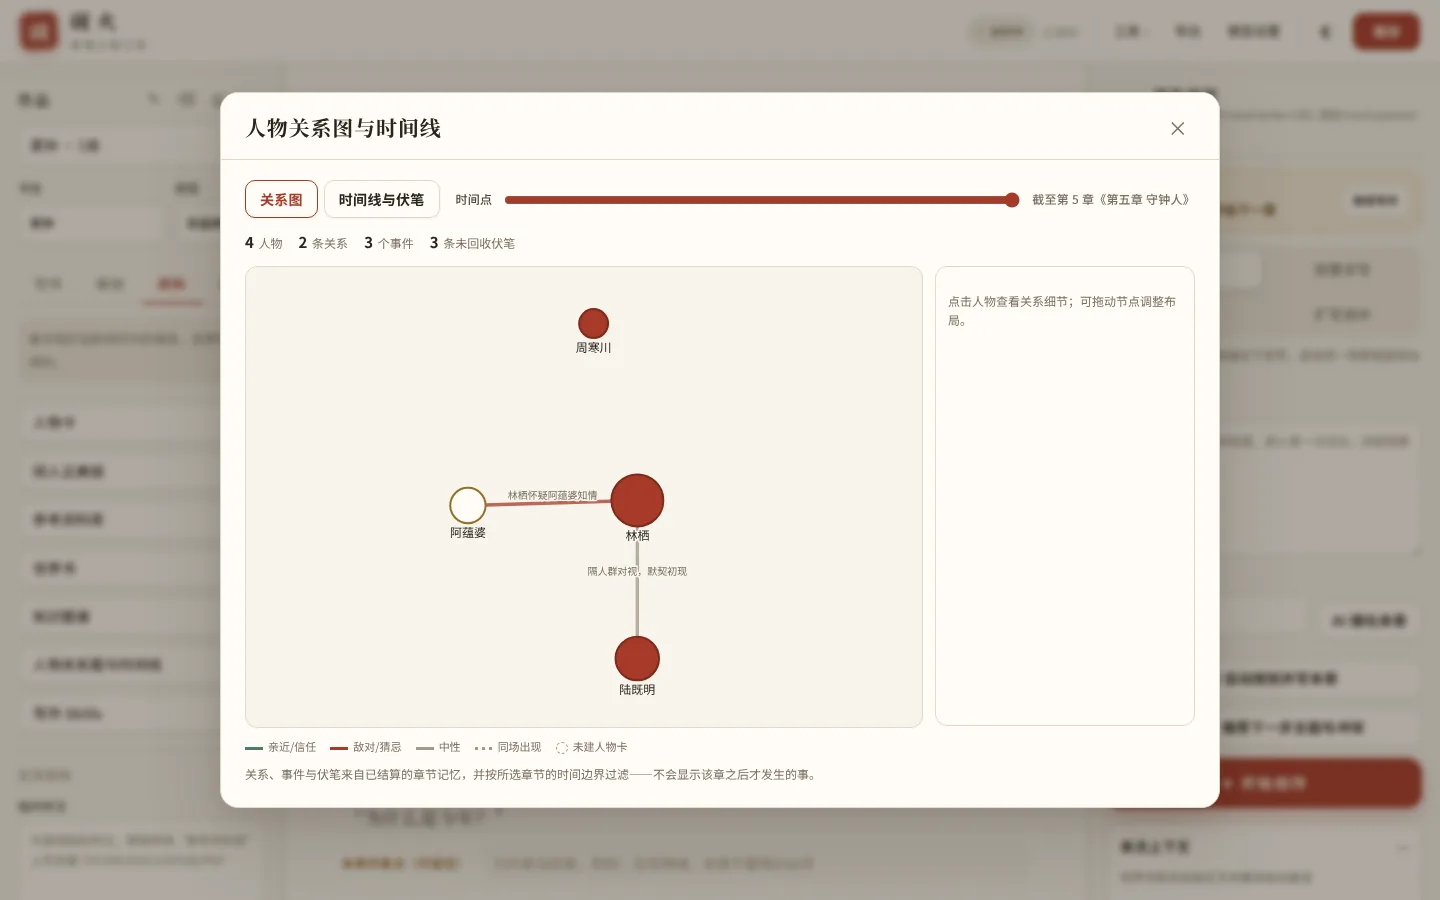
检索:FTS5 + 类型配额
全文检索是一张 FTS5 虚表,它只是可重建的投影,作品 JSON 才是事实源,并且只增量更新变化的文档。生成时结构化状态和旧正文片段一起排序,默认取 12 条,但每种类型有配额上限(章节 40%、正文片段 30%、事实 45%、线索 30%、时间线 20%、关系 25%、人物知情 25%),避免大量相似的旧正文挤掉世界规则或当前人物状态。去重用贪心的 MMR 式选择:每个候选按“分数 − 2.2 × 与已选项的最大 Jaccard 相似度”排序,相似度超过 0.92 的直接丢掉。
整个上下文是可审计的:提示词预览显示每个区块的优先级、估算 token、来源和裁剪轨迹;每次正文生成都冻结实际消息、检索来源、技能、预算裁剪和提示词 SHA-256,换了模型配置也能回放。
审校与精修:检查—修订—复检—接纳
本地质检先跑确定性问题:长度、元话语、Markdown 残留、复述原文、循环措辞、套话、疑似截断,以及历史题材的时代用语门禁(统计现代术语密度,可设白名单和“主角可用的现代词”,叙述按 1/3 计、对白按原值计)。
五类分项审校(review/focused_critics.py,参照 ConStory 的分类):人物记忆与能力、事实细节、视角与语气、时间线与因果、世界规则与地理,交锋场景再加一个辩论强度审校器。每个审校器只拿本类需要的上下文。为了省调用,先按风险信号打分:低风险章节合并成一次审计,合并审计发现需要升级的问题,再自动展开成五个分项。截图里的第三章就是先合并审计一次,报出中等问题后展开了五个分项审校。
证据编号:草稿按 [P段-S句] 编号送审,模型只返回证据编号,本地按编号取回原句,先精确匹配再模糊匹配(≥ 0.9)。存下来的引文永远是原稿文字,并绑定稿件哈希。高、中严重度的问题如果没有有效证据,就保持“待复核”,不计分。
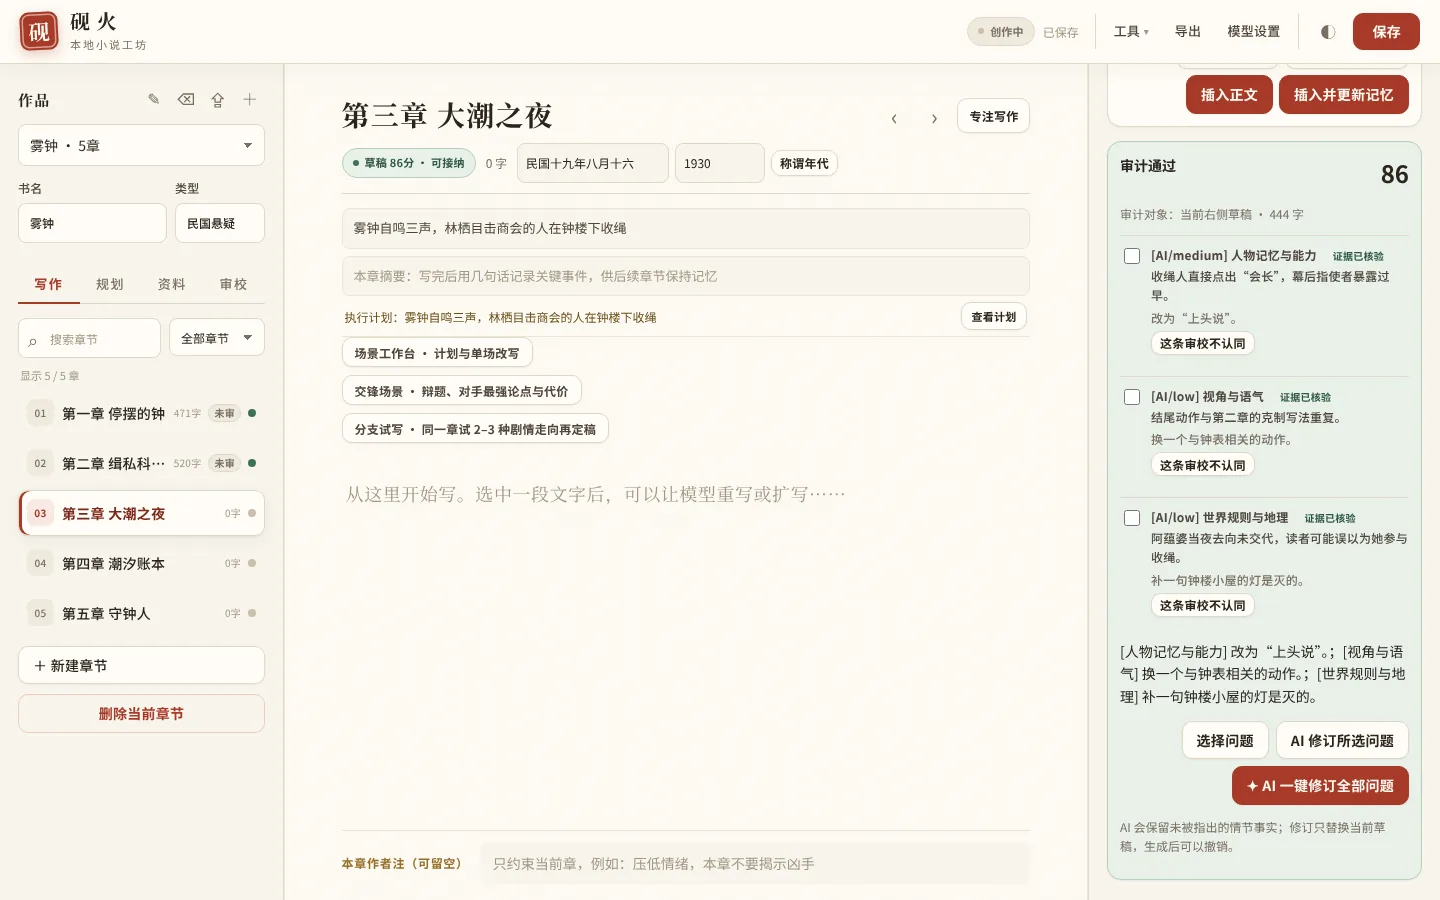
修订优先按证据定位到问题段落,只重写那一段;找不到可定位的证据才整章重写。修订复核只逐条判断上一轮的问题是已解决、部分解决还是未解决,增量审计只看改动过的句子;全量审计只在首次、改动过多或上下文变化时跑。
AI 自动精修把这些串起来:审校 → 修订 → 复审 → 硬规则扫描 → 锁定 → 记忆更新,每章尝试 2~4 次,达到目标分才接纳;没通过的版本留在检查点里,原正文保持不变。连续 3 轮提升不到 1 分、或者同样的问题反复出现,就停下来标成“需要作者处理”,而不是无限地烧调用。
开写前设定预检
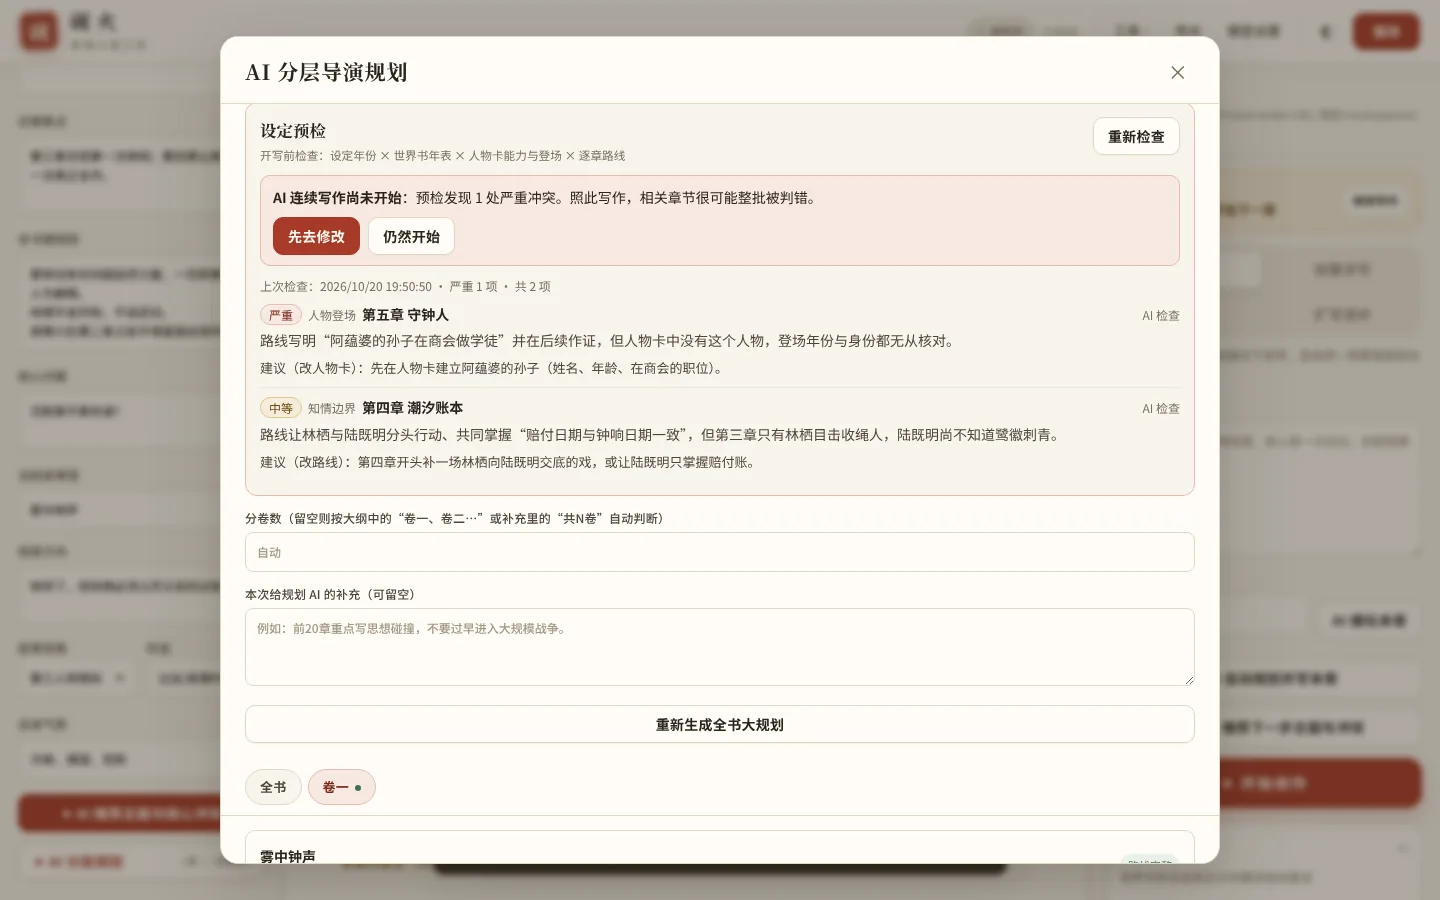
这是最新版本加的能力(planning/preflight.py)。很多连续性问题其实在开写前就能发现:路线里出现了人物卡里没有的人、人物在出生之前登场、角色掌握了他还不知道的信息、称谓不符合年代。预检分两层:本地规则核对路线年份与人物生卒和登场年、称谓年代表和禁用语、起始年份与常驻世界书的年表;再加一次结构化的模型调用,把冲突归类为年代、能力、知情、人物登场、规则等,并指出该改设定、路线还是人物卡。有严重冲突时,“AI 连续写全书”不会开始,除非作者明确选择“仍然开始”。
截图里,模拟模型报出“第五章路线写了阿蕴婆的孙子作证,但人物卡里没有这个人”和“第四章路线让陆既明掌握他还不知道的信息”,系统阻止了连续写作。
自动导演:长流程必须能中断和恢复
“一键创作全文”听起来像一个按钮,实际是整套系统里最复杂的工作流:开书、人物、全书规划、分卷、拆章、逐章正文、审校、修订和记忆结算,任何一步都可能超时、断连或返回不完整的结构。
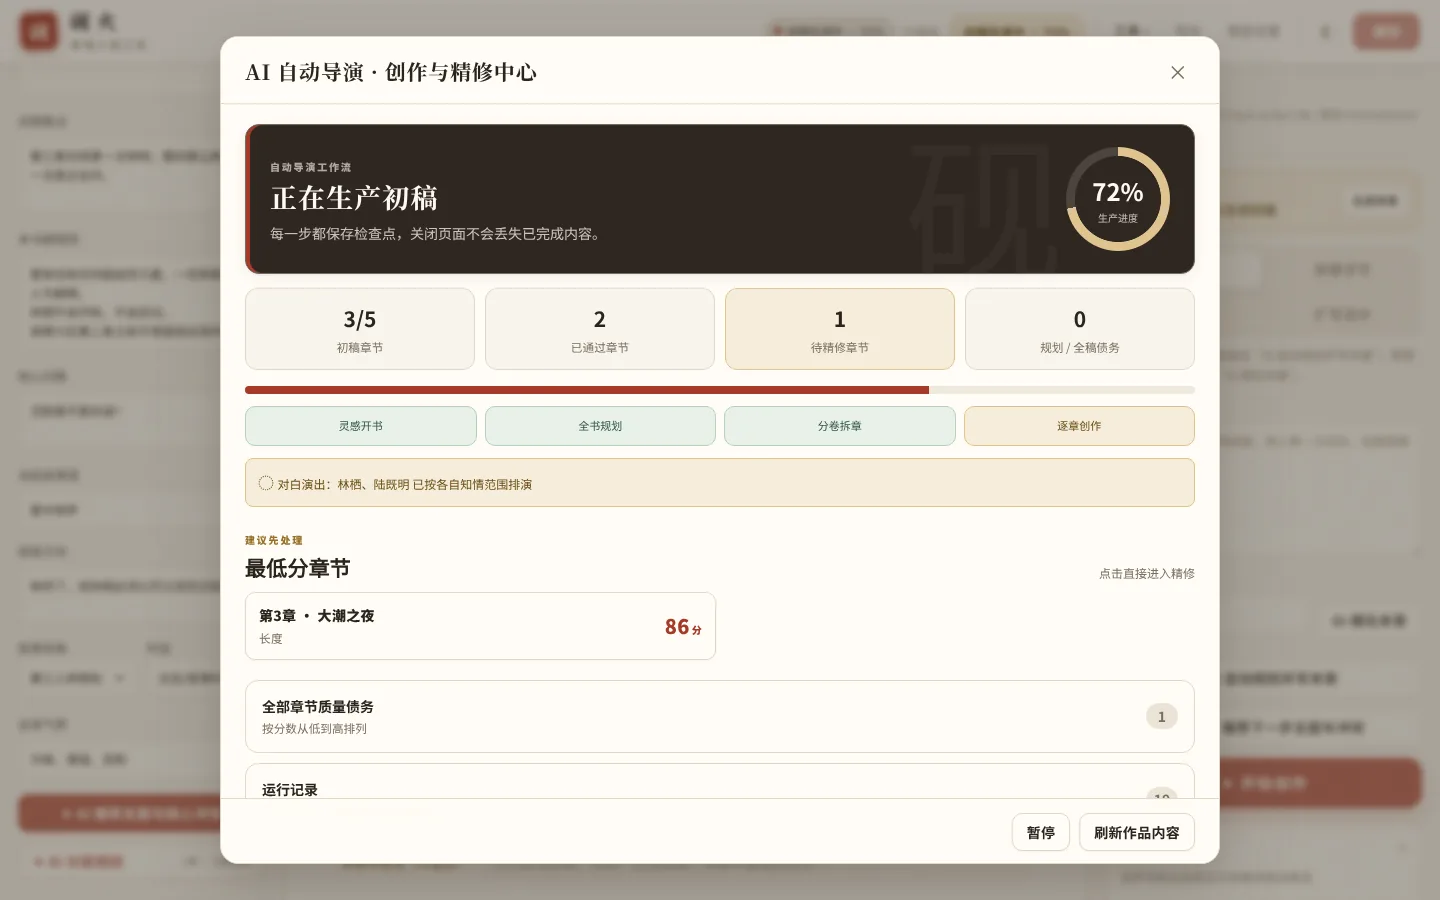
实现方式不是让一个巨大的请求承担所有工作,而是拆成可持久化的阶段:开书骨架 → 全书圣经与分卷 → 逐章路线 → 逐章执行 → 全书精修。
- 检查点:每一步写进 SQLite 的任务表,关掉浏览器任务也照样跑,重新打开后界面从数据库读取真实状态,而不是依赖页面内存里的进度条;
- 正文流检查点:按“完整消息 + 生成设置”的哈希绑定,第一个片段立即保存,之后约每 2 秒保存一次,暂停、断线、完成时也立即保存;同一章最多保留 32 个场景回执。“模型说完成了”和“正文是否完整”分开判断,前端在收到完成回执之前不会进入完成状态;
- 租约:导演持有一个默认 90 秒的租约并定期续约,配合作品库的独占实例锁。服务重启后,失去租约的任务会转为可恢复状态;
- 质量熔断:章节没达标会累计“质量债”,连续 3 次系统性问题或 5 次质量问题就暂停,提示“已触发质量熔断,当前低质量候选未写入正文”。差阈值不到 10 分、又没有严重问题的“差一点”的章节只进精修队列,不累计债。
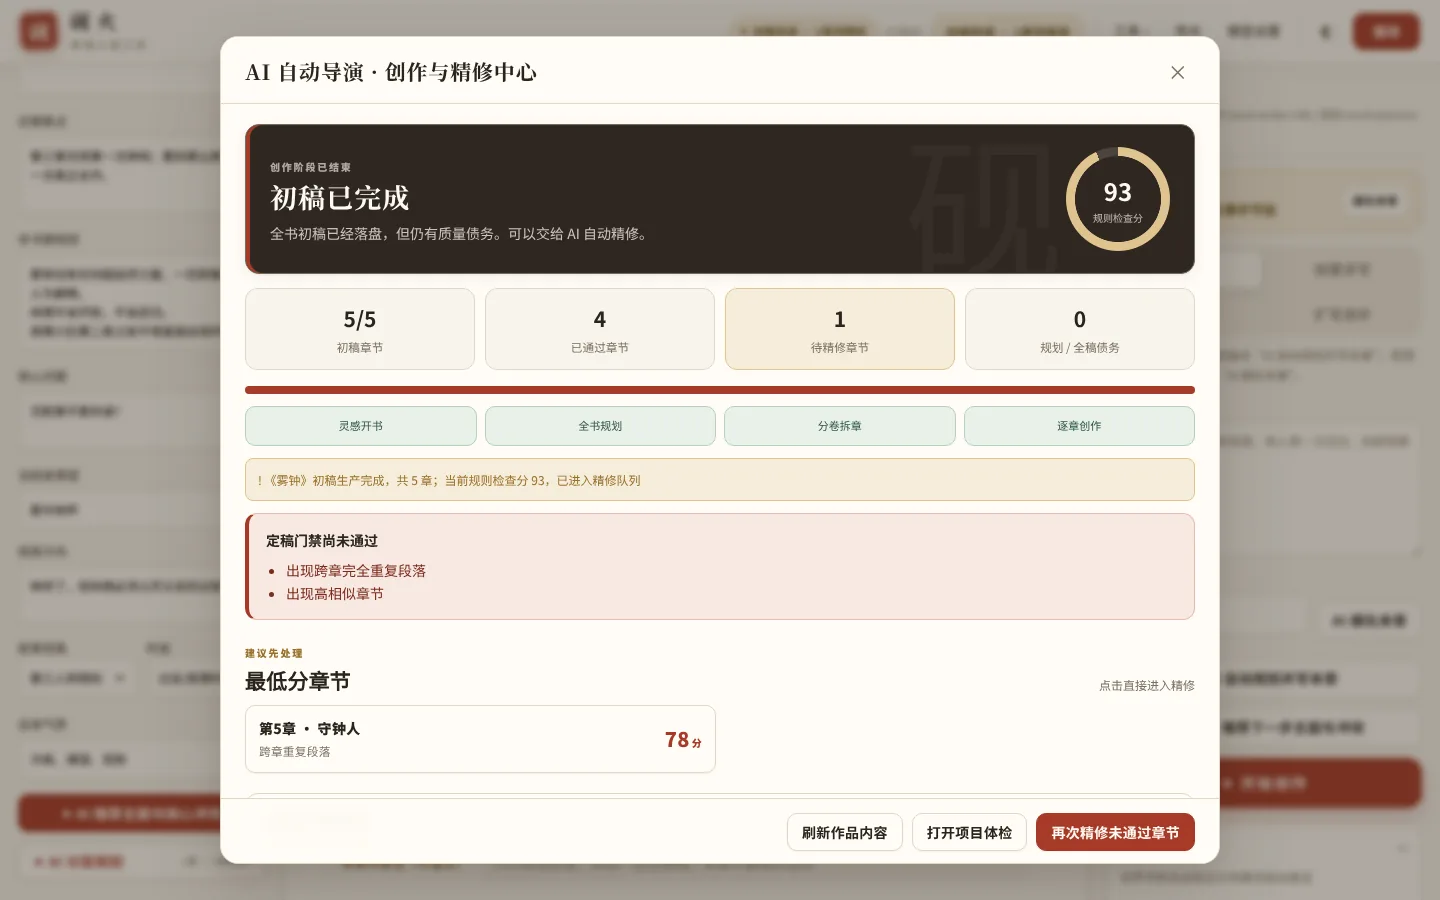
定稿门禁与项目体检负责最后一道关:跨章重复段落、高相似章节、分卷阶段雷同、全稿健康分低于定稿线(82 分)都不放行。截图时模拟接口有个缺陷,把同一段正文返回了好几次——砚火识别出了跨章完全重复的段落,把第 5 章隔离进精修队列,运行记录写着“第 5 章已进入精修队列,未污染正式记忆”。这个“意外”正好展示了门禁的价值。
数据安全
- 乐观并发:浏览器保存必须带上它看到的版本时间,服务端在事务里原子比较,不一致就返回 409,弹出“检测到其他位置的更新:下载本地副本 / 重新载入”。另一个窗口或后台任务改过作品后,旧页面不能静默覆盖;导演运行时禁止手动保存;
- 快照:每章在保存、接纳草稿、导演写入前都保留独立快照,还有项目修订历史和章节版本恢复;
- 凭据:Key 存在独立的 secrets 数据库里,Windows 用当前用户的 DPAPI 加密,其他系统用权限受限的本机随机密钥;Key 不进作品 JSON、历史版本、上下文快照、备份和导出;调用统计存在另一个库里,不存正文、提示词和地址;
- 备份:每小时检查一次,自动备份保留 24 份,手动备份保留 12 份;恢复前先拍安全快照,恢复后再校验,任何一步失败都回滚;
- 升级:旧库第一次打开前留一份原始副本再做幂等迁移,更高版本的库会被拒绝打开;源码启动前按代码指纹建一份回滚副本,可以一条命令回滚;
- 测试隔离:测试在导入应用之前就把所有路径指向临时目录,一旦写进仓库的
data/就直接失败。
部署:双击之后自动准备环境
如果只能在终端里运行,它就仍然只是开发者工具。所以有三种发行方式,最终都进入同一个服务入口(默认 127.0.0.1:7860):
- 自动部署版:解压后双击
InkForgeLauncher.exe。启动器检查 Python,缺失就从官方固定地址下载并校验 SHA-256;按“应用版本 + 依赖指纹”建立隔离环境;启动服务、等健康检查通过后打开浏览器。依赖缓存齐全后可以离线启动。作品、凭据、日志和备份都在当前用户的数据目录里,更新或重新解压不会覆盖小说; - 便携版:PyInstaller 打包,检测到 Inno Setup 时再生成安装程序;
- 源码运行:
run.bat/run.ps1。
发布前有一个“版本契约”检查:应用、前端资源版本号、启动器、安装脚本和文档里的版本必须一致。还有一个真实模型验收脚本:用隔离的数据库跑多章连续创作,第一章后强行杀掉服务,重启后验证任务可以恢复,报告自动脱敏。
六、开发中的几次关键转折
1. “自动审查后分数不会改动,另外经常断掉,让我重新从检查点生成。” 这是我在 9 月测试时提的一个问题,它其实是两个问题。分数不动或者反复跳,是因为修订稿每次都被全量重审,新的审校又会发现新的小毛病——于是有了“修订复核”:只核对上一轮的问题和改动过的句子,同类问题递减计分,审校器自己写“实际不矛盾”“需确认”的条目降为提示。经常断掉,是因为把“模型说完成了”和“正文完整了”混为一谈——于是正文流检查点按输入哈希绑定、每 2 秒持久化,finish_reason=length 时最多做几次接收尝试,导演接纳的正文先落盘再提取记忆,被供应商内容过滤的输出也不再用无效的提示词反复重试。
2. 云端模型写的全书大纲只有 400 字。 同一个 JSON 要装十几个字段,模型会把总纲压得很短,再要一次 JSON 也没用。解决办法是把总纲拆成一次单独的纯文本调用;同时发现截断的 JSON 重试只加 256 个 token 根本不够,改成预算翻倍,云端模型的规划输出上限也整体放大。
3. 质量熔断太敏感。 熔断的初衷是“连续多章不达标,说明规划或提示词有系统性问题”,但只差几分的章节也被算进去,导演频繁停下来。后来引入了“差一点”的判定,这类章节只进精修队列;顺手修了两类误报:“像想起了什么似的”这类动作描写被当成非法回忆,审校器写了“需确认”却仍被计分。
4. 早期作品的专名写进了校验器。 早期一直拿同一部作品测试,路线和时代检查、去重停用词里不知不觉写死了那本书的人名、朝代和年份,换一本书就误判。v0.35 先改成 8 套题材档案,最新版本彻底改成读取作品自己的称谓年代表、人物年份、禁用语和人物表,还写了一个测试扫描源码,防止专名回流。
5. 重构后启动器自己挂了。 v0.37 把原来 1300 行的 db.py 拆进 storage/ 包以后,run.ps1 每次启动前运行的升级保护脚本还在给旧文件算指纹,直接让启动中止。这是“保护脚本也要跟着重构走”的典型例子。
6. 从加功能到删功能。 0.34 加入过连载发布面板和读者模拟,0.37 把它们删掉了(旧数据原样保留,只是不再读取),让项目重新聚焦在“把小说写完”这件事上。同一轮重构列出了问题清单:app/ 根目录约 40 个松散模块、prompts.py 约 1500 行、依赖关系成网,最后按 11 个包重排、用架构测试锁住依赖方向,所有提示词文本都逐字节比对过,确认重构没有改变模型看到的内容。
回头看,很多结构不是一开始就设计好的,而是在真实问题出现后形成的:页面关闭后进度消失,促使任务状态进入数据库;精修“完成”却没有真正通过门禁,促使修订和复检分离;双模型设置难以理解,促使界面回到一个接口的简单选择;早期正文修改污染后文,最终促成了证据记忆与失效重建。问题不是通过增加更多提示词解决的,而是通过重新划定系统的责任解决的。
七、版本历程
| 版本 | 主要内容 |
|---|---|
| v0.33.1 | 第一次工程化重构;证据记忆;自动导演检查点;Windows 自举启动器;69 项测试 |
| v0.34 | 证据编号与模糊匹配;五类分项审校与风险分级;时代用语门禁;去套话;对白演出;关键章多候选与双向盲评;6 步记忆提取;道具伤势状态机;伏笔欠账;滚动重规划;关系图与时间线;TXT / EPUB / DOCX 导出;模型设置改为单一 Base URL |
| v0.35 | 修订复核(分数不再反复下跌);历史题材支持;交锋场景工作台;8 套题材档案;真实用量与成本统计;新书向导 |
| v0.36 | 评分校准;整卷回顾;分支试写;导出前清理;GitHub 私人仓库备份;首启演示作品 |
| v0.37 | 删除连载发布和读者模拟;“发布门禁”改名“定稿门禁”;后端 11 个包 + 架构测试;规划总纲纯文本扩写;质量熔断调整;开写前设定预检;校验器不再内置任何一本书的专名;647 项测试 |
八、当前边界
- 文风学习是检索和提示词层面的软学习,不是模型微调;
- token 数是本地估算;
- 连续性审计能降低事实错误,但不能替代作者对关键设定的确认;本地规则擅长发现机械问题,不能评价主题深度和文学价值;
- 不同模型的中文表达、结构化输出和长上下文能力会直接影响最终效果;
- 截图时还遇到过一次误报式的冲突提示:在输入框打完字立刻点“开始创作”,自动保存和候选稿登记先后到达,弹出了“检测到其他位置的更新”。数据没有被覆盖,但对用户来说是一次打扰,自动保存应该在登记候选稿时让路。
九、最后的复盘:AI 写作工具应该帮作者什么
真正消耗作者精力的,不只是把一句话扩展成一段文字,而是长期维护作品的复杂性:人物为什么做出这个选择,某条信息从哪里来,谁在什么时候知道了什么,一次修改影响到哪些后文,以及模型生成的内容是否值得成为正式手稿。
所以砚火追求的不是让作者退出创作,而是把最适合结构化管理的工作交给系统:整理状态、维护证据、检查连续性、记录历史、提示风险,并把复杂流程变成可以暂停、恢复和回退的步骤。
模型负责提供可能性,系统负责保存秩序,作者负责决定作品最终成为怎样的故事。
项目地址:GitHub · star031104/inkforge-local
让模型记住故事,让作者掌握方向。
系列文章