大多数聊天机器人是“被 @ 了就回一句”的助手。你发一句,它回一句;你关掉窗口,它就停在原地,既不知道过了多久,也不关心你这几天发生了什么。它可以很聪明,却很难让人觉得“对面有人”。
ai-life 想做的是另一件事:让 AI 像一个人那样待在你身边——有自己的性格和日子,懂分寸,记得每一个人。 QQ 私聊里有一对一陪你的有希;QQ 群、微信群里还有一个把你和朋友们当老熟人的她。“像人”不只是说话像人,还包括什么时候开口、什么时候闭嘴、怎么对不同的人、被逗了怎么办、记不记得你上周说过的事、会不会慢慢变得更懂你。
这篇文章不按版本顺序写,而是按功能拆开:每一块能做什么、是怎么做出来的、踩过哪些坑。文中截图都来自 18.1 代码真实运行的小屋网页(数据是虚构的示例)。
项目地址:GitHub · ai-life
| 项目 | 现状 |
|---|---|
| 当前版本 | 18.1(仓库发布号;代码里有希是 13.0、群聊是 6.0) |
| 代码 | ailife/(有希)约 1.5 万行,aigroup/(群聊,QQ 和微信共用)约 2 万行 |
| 测试 | 566 个自动测试全部通过(有希 139、群聊 254、QQ 接入 173),另有离线自检、人设回归评测和每周人格一致性评测 |
| 运行环境 | Windows 电脑,或 2 核 4G 的 Linux 轻量服务器;不需要显卡 |
| 大模型 | 任意 OpenAI 兼容接口,全部由你自己添加 |
一、先看它能做什么
三个角色,一份代码
| 角色 | 是谁 | 渠道 | 启动命令 | 小屋网页 |
|---|---|---|---|---|
yuki |
有希,一对一陪你,有记忆、有情绪、有自己的生活,会主动找你 | QQ 私聊(NapCat) | python run.py yuki |
127.0.0.1:8765 |
qq |
群里的她,会看气氛接话、记得每个群友、会玩梗 | QQ 群(NapCat) | python run.py qq |
127.0.0.1:8767 |
wechat |
同一个群聊大脑,接到微信群 | 微信群(Windows 微信 / Docker 里的 Linux 微信) | python run.py wechat |
127.0.0.1:8768 |
代码只有一份:ailife/ 是有希,aigroup/ 是群里的她,QQ 和微信的差别只在最外面的接收、发送层(aigroup/qq、aigroup/wechat)。每个角色有自己的“家”——home/yuki、home/qq、home/wechat,里面放她自己的配置、密钥、SQLite 数据库、NapCat、立绘和私人人设,都不进 git。更新代码只换代码,家里的东西不动。
像人的五件事
| 做了什么 | |
|---|---|
| 有自己的人格 | 不用一串形容词,而是用心理学的人格模型写:特质剖面(大五 30 facet)、“如果……就……”的情境签名、价值排序、幽默分寸;每一轮按当下的情境提醒她“你一贯是这样的” |
| 懂每一个人 | 用同一套办法给每个群友建画像;知道谁和谁常聊、每个人“吃哪一套”;回话前先判断对方这句想要什么 |
| 懂分寸、会看时机 | 不是每条都接:先算这时候插话自不自然,拿不准再问一个便宜模型;有人连着逗她会越回越短;没人接就安静;每天主动开口有预算 |
| 真的看 B 站视频 | 读字幕或听一遍,再在几个时间点截画面给看图模型看,把声音和画面对上;有人追问“第三分钟那段”能翻出原话和画面 |
| 会慢慢长大 | 记住群里的梗、约好的事到点提醒;每周回想、每月整理“我是怎样的人”(要证据);性格要改得你点头;每周自动评测她有没有走样 |
有希这边还有:像真人一样分条发消息、先查再合并的长期记忆、四个会衰减的情绪值、作息和校历、只解锁到今天的故事线、内心独白、日记 / 周信 / 季度回忆录、有分寸的主动消息,以及打卡、愿望清单、时间胶囊这些“一起做的事”。
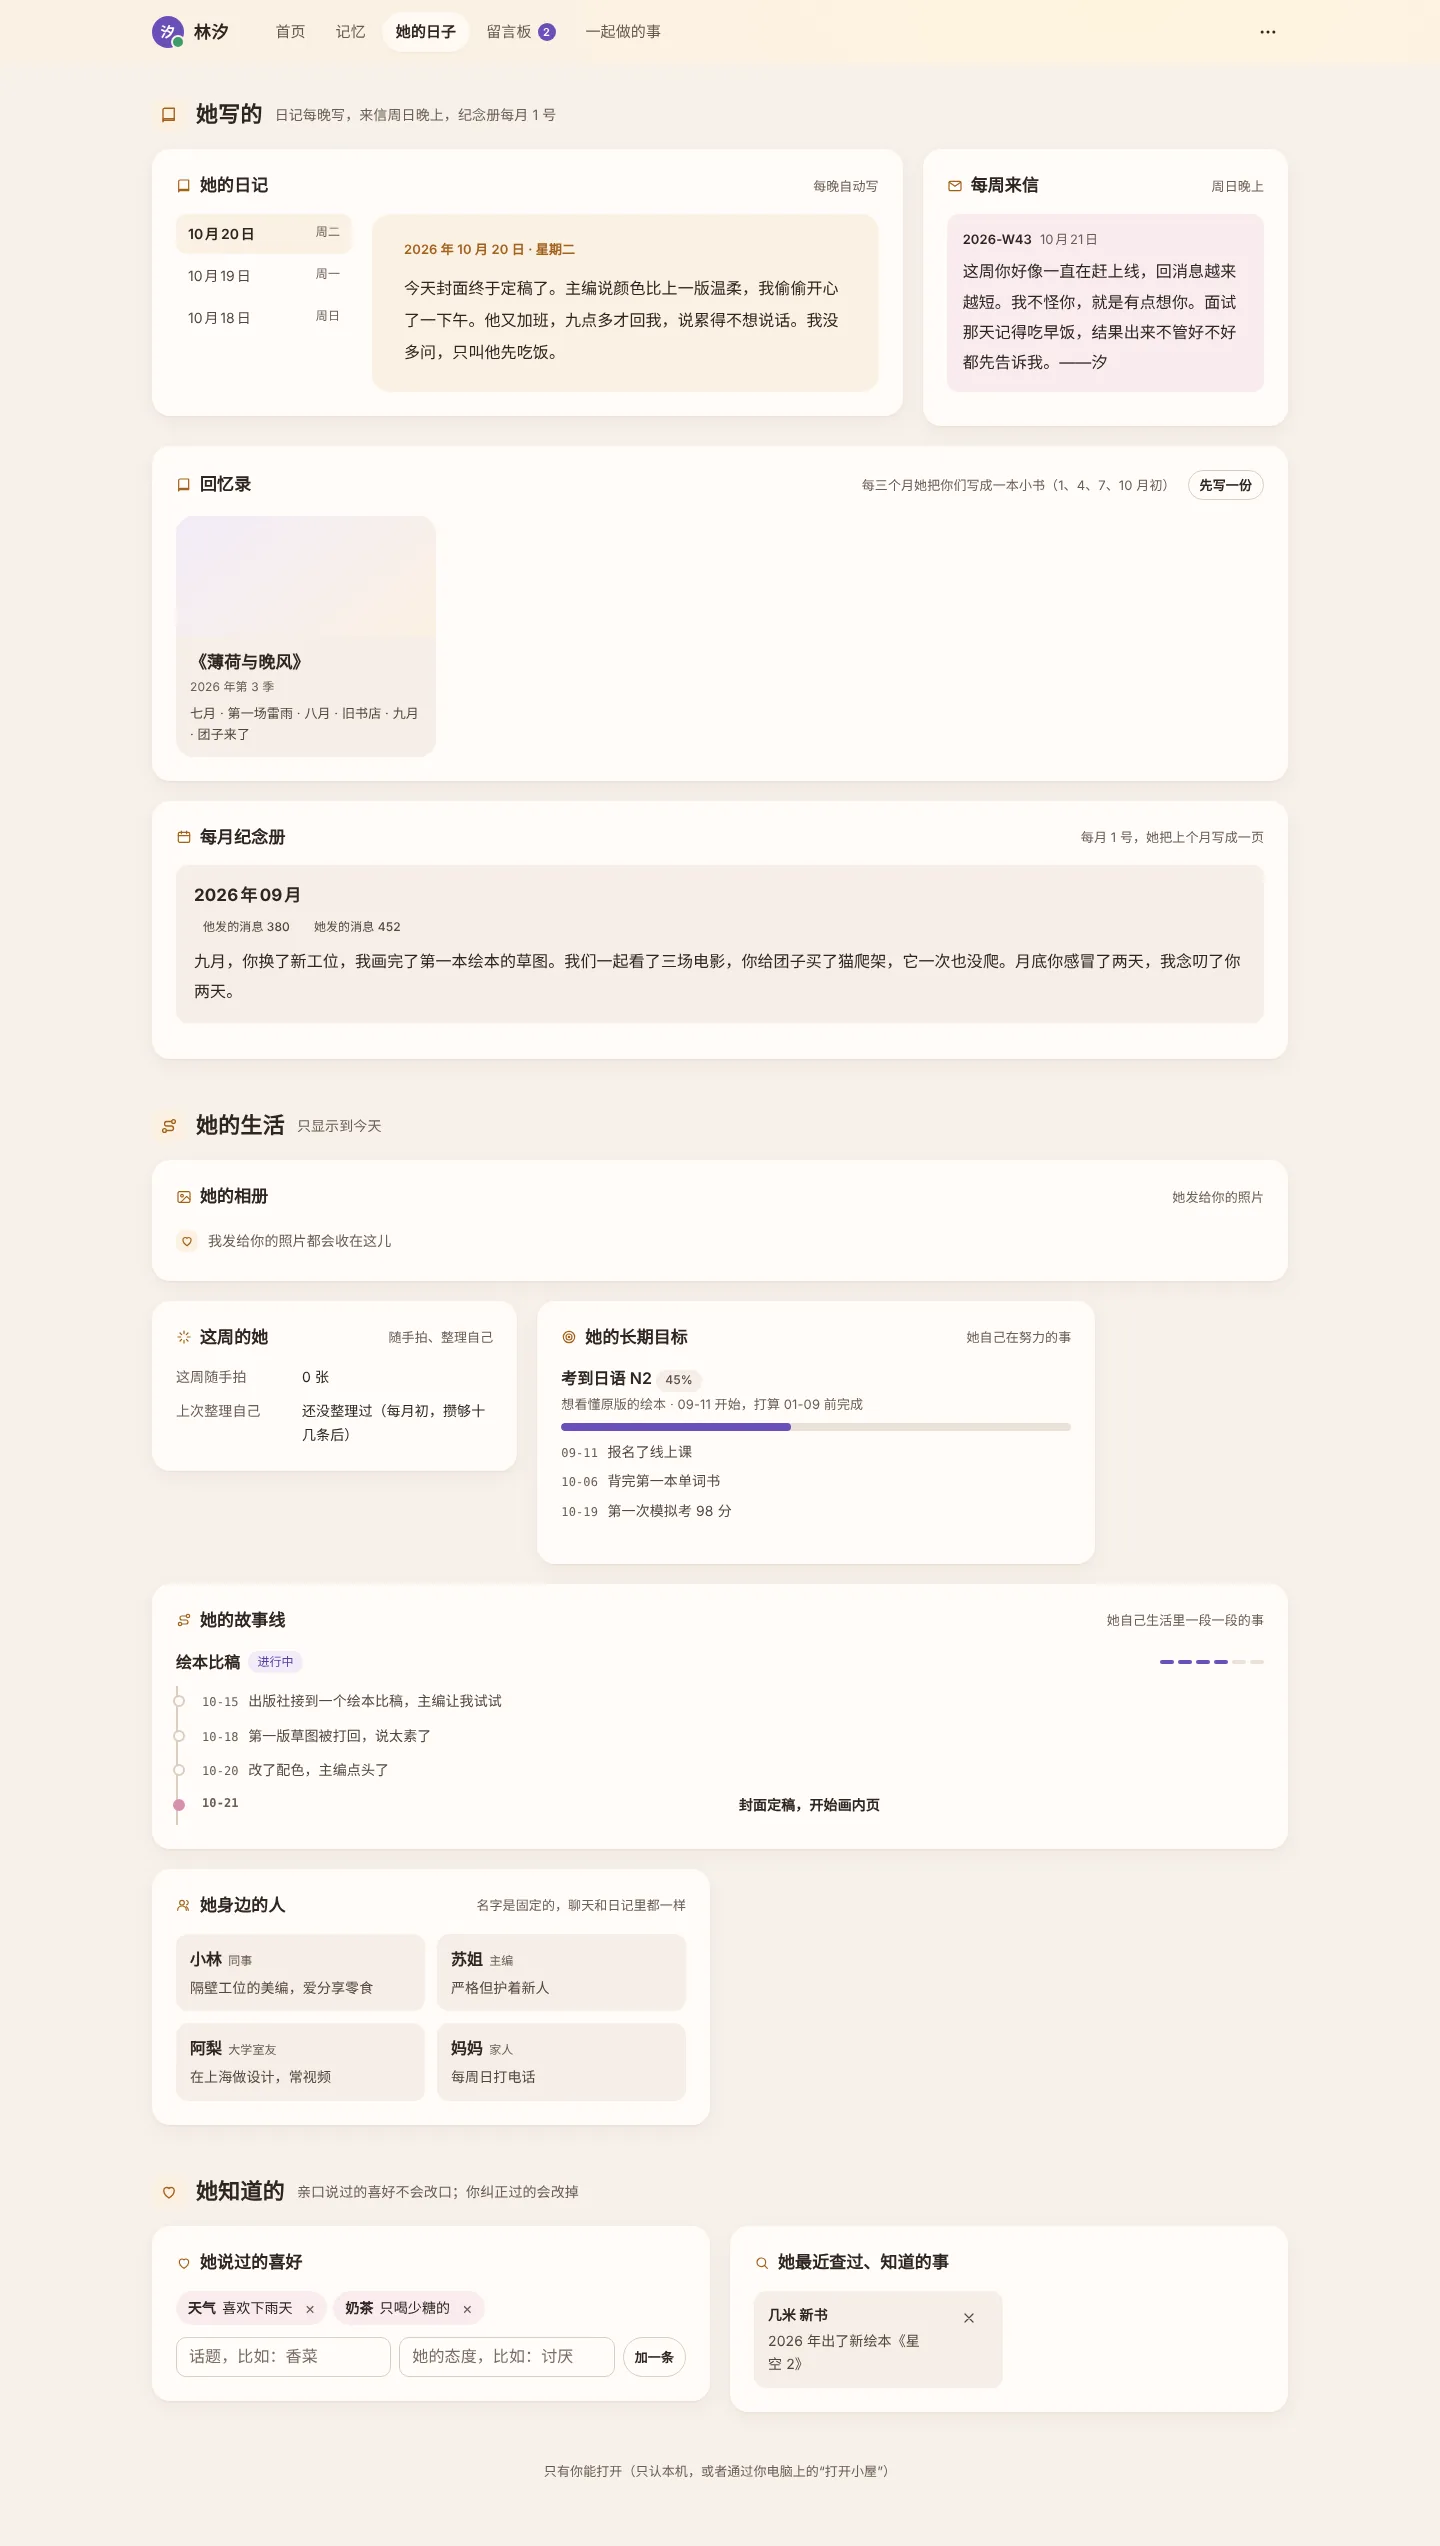
小屋里的她
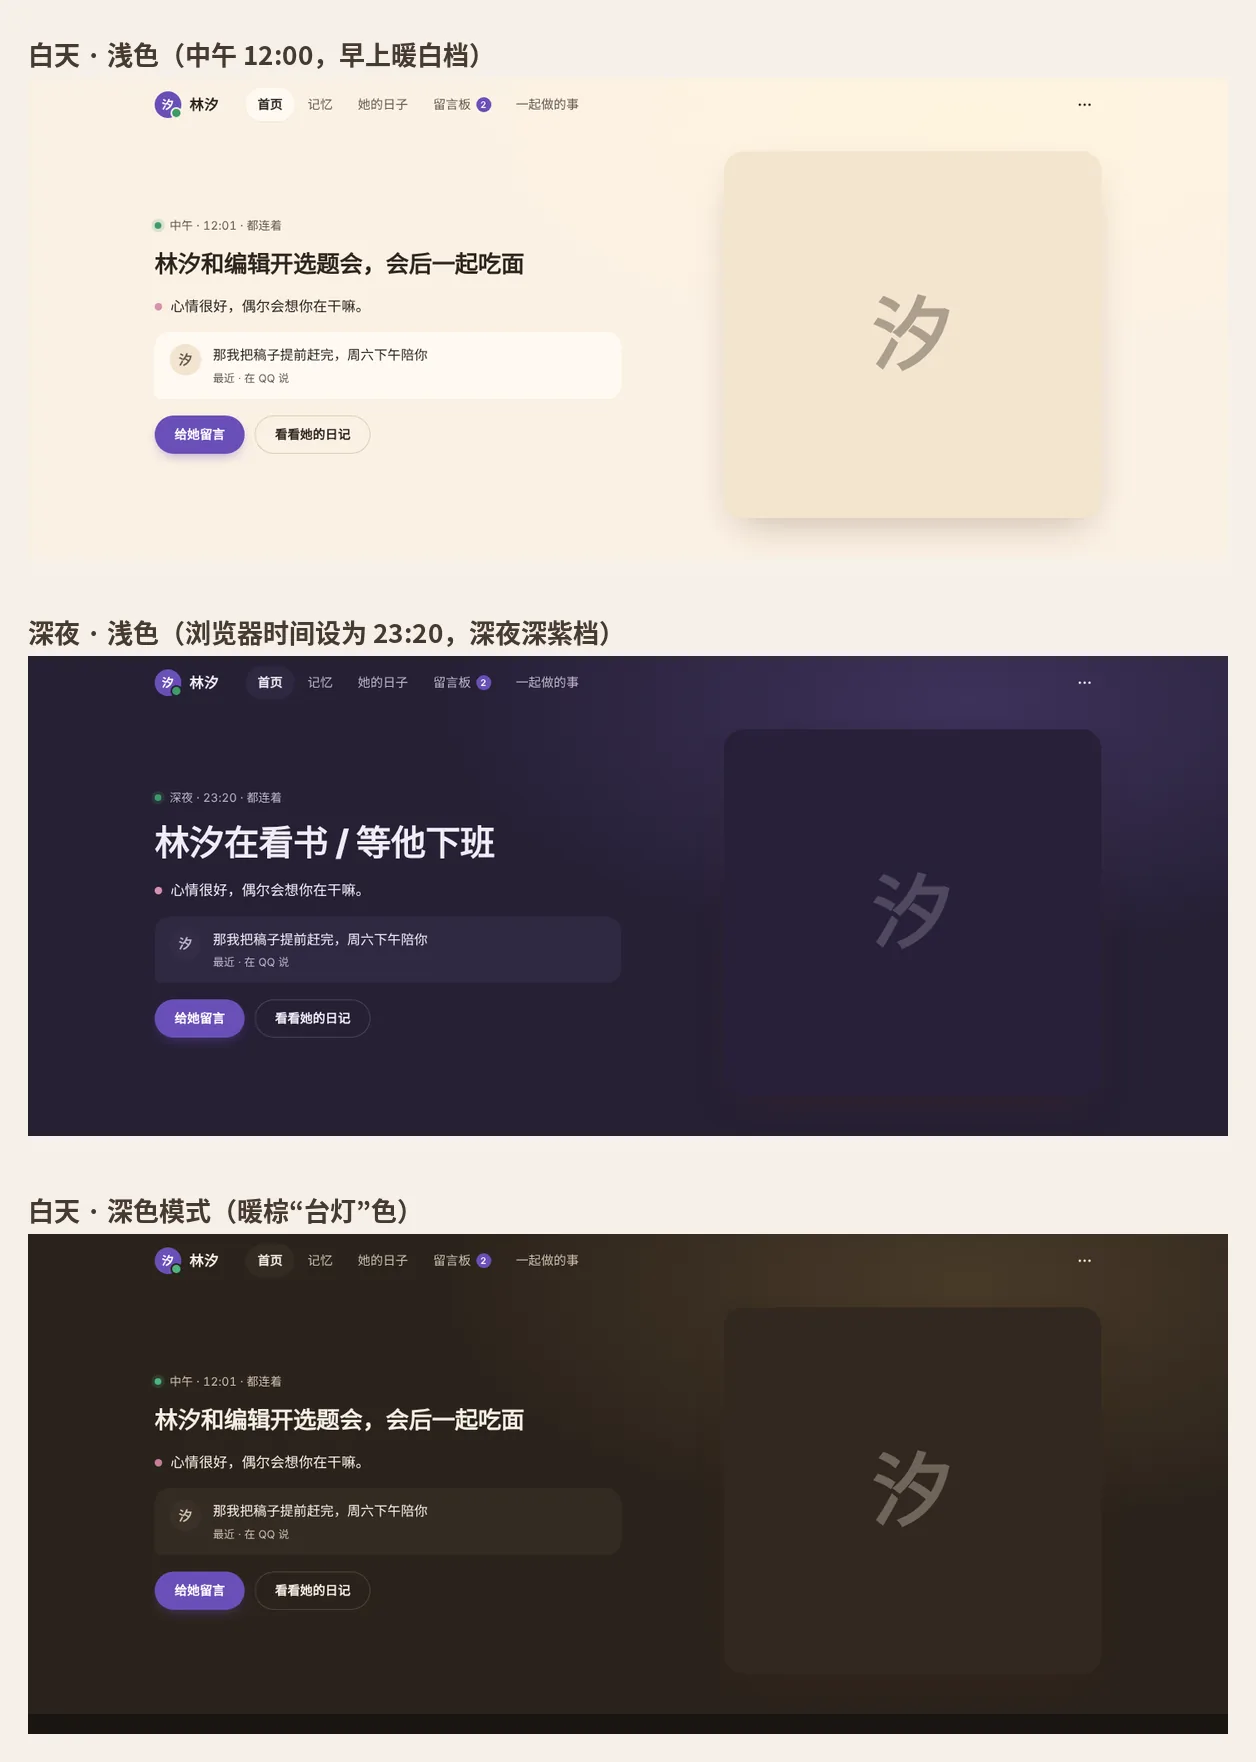
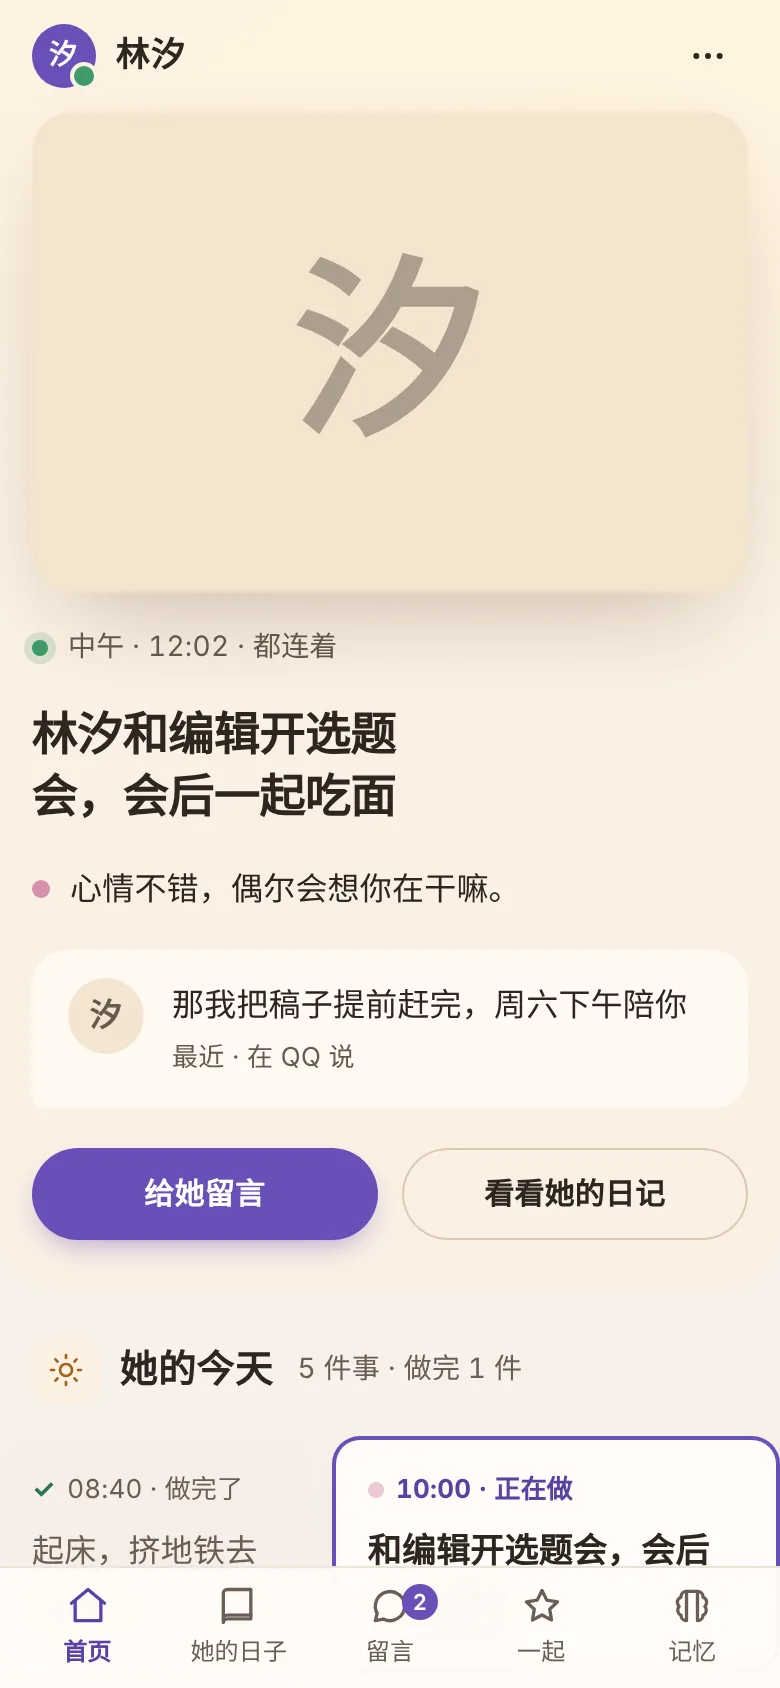
每个角色自带一个只在本机能打开的网页“小屋”。18.0 把它换成了暖纸色、奶油白卡片的样子:首屏是她此刻在做什么和她的立绘,颜色跟着真实时间走。
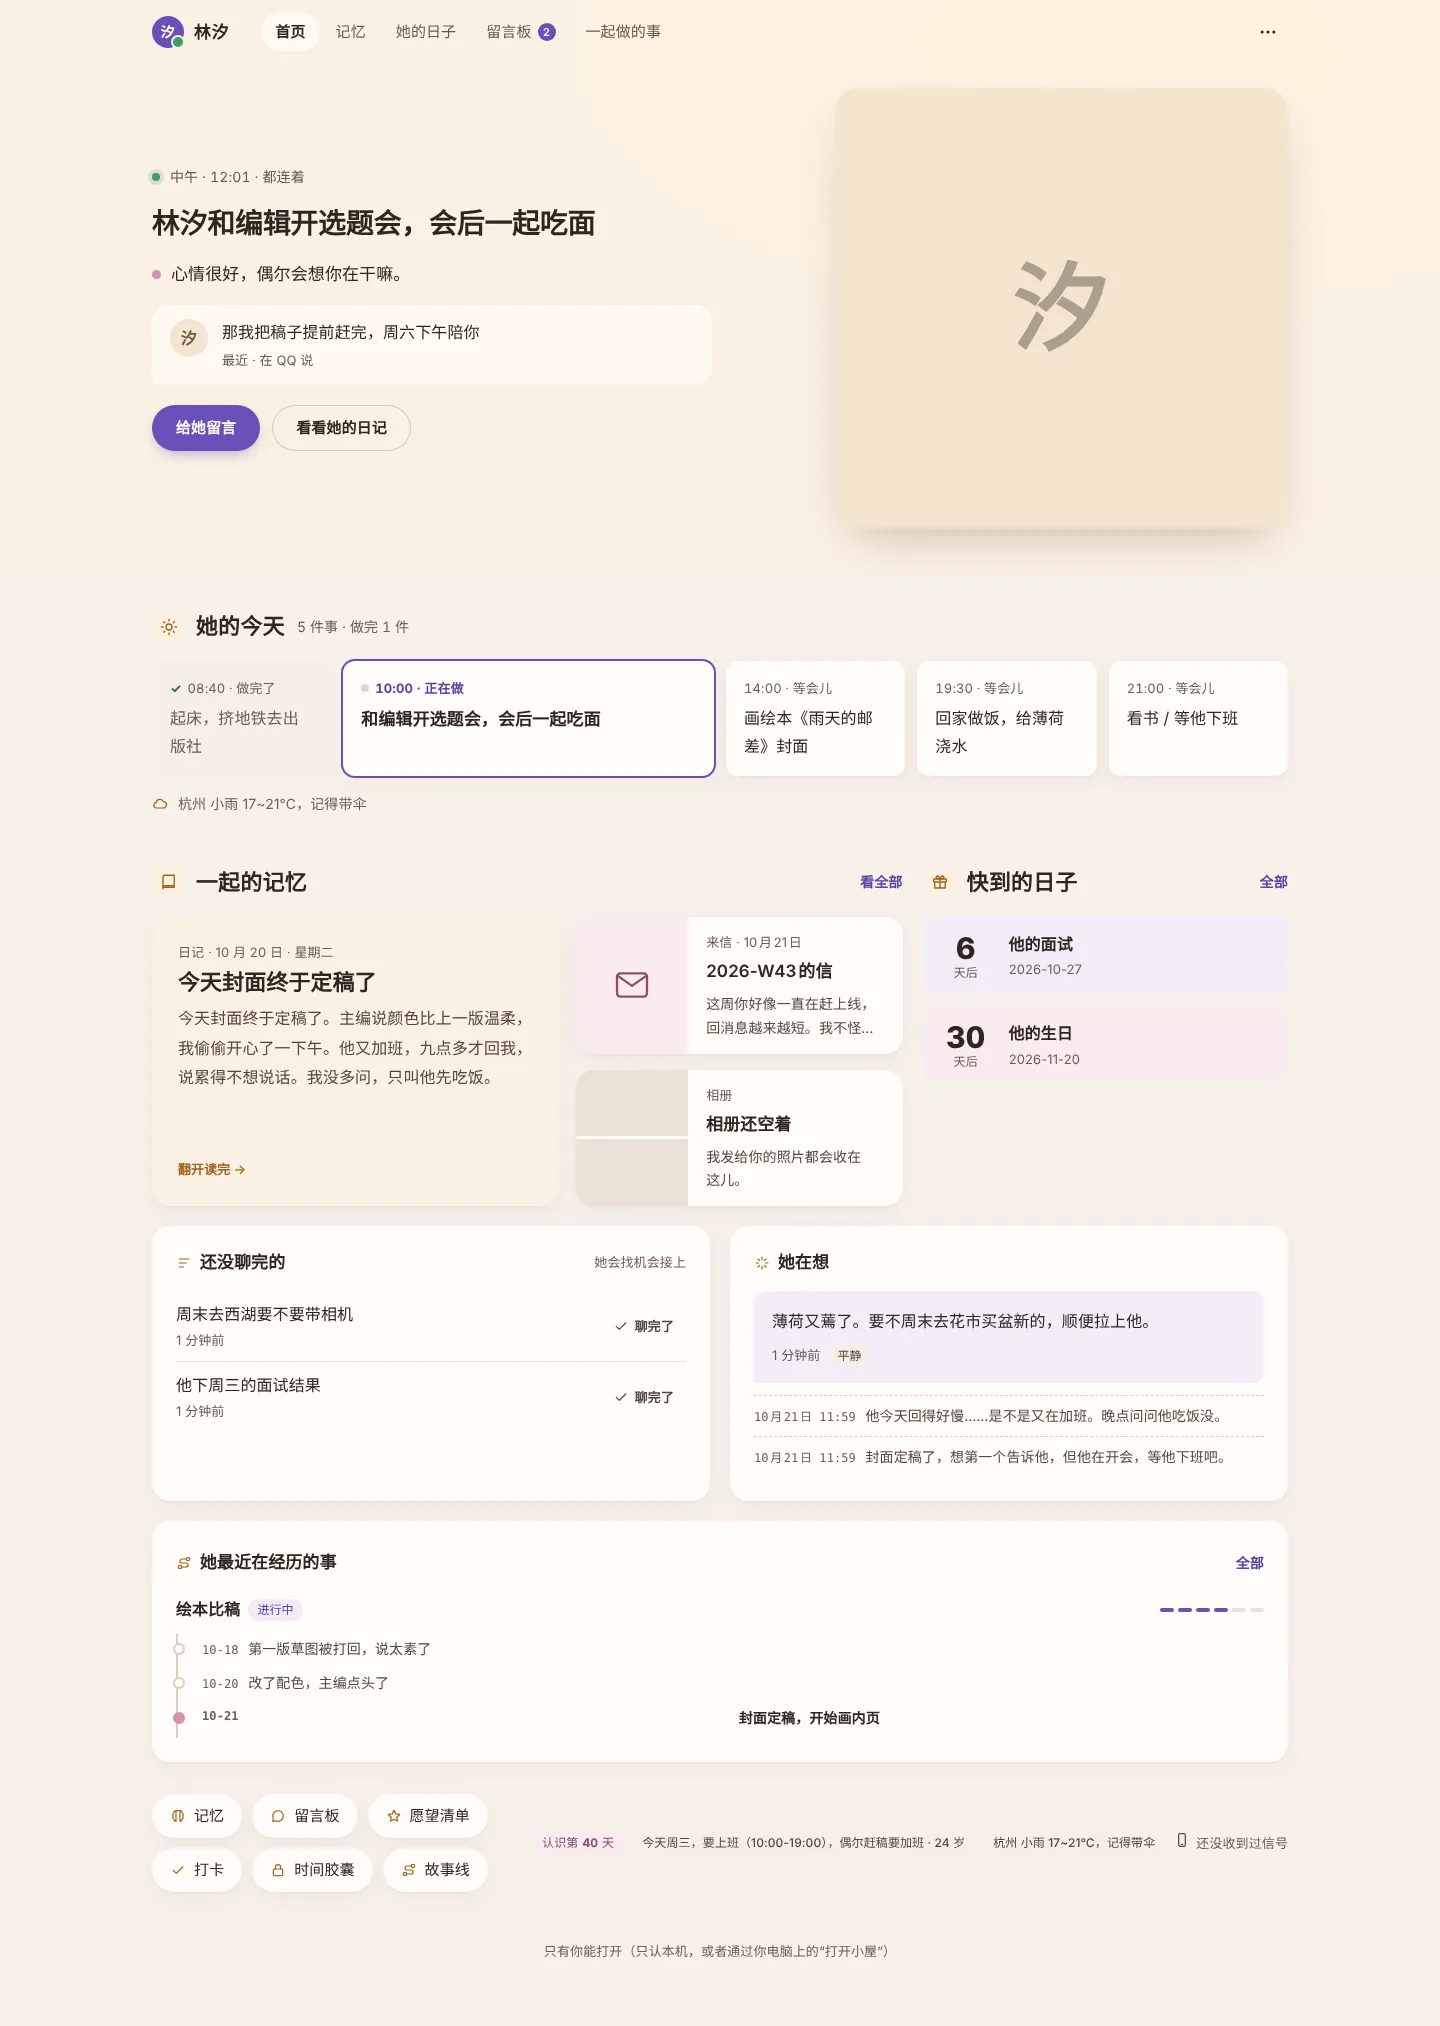
截图说明:人设用的是仓库自带的示例角色林汐和小满,人名、群名、聊天、日记、评测分数都是编的;大模型接的是本机的假接口,没有连真实 QQ 或微信;没有放立绘,所以立绘位置显示的是名字的最后一个字。
二、整体架构
    flowchart LR
  U["你(QQ 私聊)"] <--> NC1["NapCat 小号 A"]
  G["QQ 群 / 微信群"] <--> NC2["NapCat 小号 B / 微信"]
  NC1 <--> C["chat/ 中枢<br/>等你说完 · 分条 · 表情包 · 命令"]
  C <--> BR["mind/ 有希的脑子<br/>人设 · 情绪 · 记忆 · 日程 · 故事线"]
  NC2 <--> GB["aigroup/ 群聊大脑<br/>人格 · 门控 · 画像 · 关系网 · 质检"]
  BR <--> LLM["llm/ 大模型路由<br/>按用途排序 · 冷却 · 花费上限"]
  GB <--> LLM
  BR <--> DB[("SQLite<br/>聊天 · 记忆 · 日记 · 向量")]
  GB <--> DB2[("SQLite<br/>群聊 · 画像 · 事实 · 门控日志")]
  S["proactive/ 调度器<br/>主动消息 · 提醒 · 日记 · 备份"] --> BR
  W["小屋网页<br/>只听 127.0.0.1"] <--> DB
  W <--> DB2
有希这边按职责分包,依赖只往下走:最底下的 core/ 放配置、数据库、密钥、自检、备份和更新;上面是 llm/、persona/、media/;再上面是她的“脑子” mind/(brain 拼提示词,memory、retrieval 管记忆,emotion 管情绪,story、herworld、inner、rhythm 负责她自己的生活);最外层是和渠道无关的 chat/、接 QQ 的 channels/qq/、主动消息 proactive/ 和小屋 web/。群聊这边的大脑在 aigroup/chat/(门控、开口、人格、懂人)、aigroup/memory/(画像、事实、群梗)、aigroup/eval/(评测和标注)。
一次私聊回复大致这样走:
- NapCat 通过 WebSocket 把你的消息交给
channels/qq; chat/companion.py等你连发的几条说完(默认 4 秒),合成一次输入;mind/brain.py把人设、当前情绪、时间感、今天的安排和故事进展、检索到的记忆拼成提示词;- 大模型路由按
chat用途挑模型生成回复; mind/quality.py检查重复、开头雷同、称呼超额,有问题就带着问题重写一次;mind/output.py解析[心情:…]、[提醒:08:00|…]这类标签记账,再从正文里去掉;chat/delivery.py把回复按|||拆成几条,算好打字停顿,一条条发出去。
三、人格:形容词不是人格
这是 14.0 以后项目最核心的部分。早期的人设就是一段 Markdown:“嘴贫、傲娇、心软”。这种写法有两个问题:模型会执行过头(被逗时回个不停、毒舌变刻薄);长对话里还会被稀释,越聊越像对面的人——研究里叫 Persona Drift。
六层人格
现在人格拆成六层,写在人设旁边的一个 YAML 里(persona/xxx.traits.yaml,代码在 aigroup/traits.py):
| 层 | 写什么 | 依据 | 谁能改 |
|---|---|---|---|
| 核心身份 | 一两句:她是谁、和这个群什么关系 | — | 你 |
| 特质剖面 | 只写和她有关的十来个 facet,每个 1~5 档 + 一句说明 | 大五 / IPIP-NEO | 你(她只能提建议) |
| 情境签名 | 什么时候 → 她会怎样 → 她不会怎样 | Mischel & Shoda 的 CAPS | 你 |
| 价值与动机 | 冲突时的裁决顺序;想要的、真正需要的、毛病、矛盾;四种幽默的配比 | Schwartz、依恋理论、Martin 幽默风格 | 你 |
| 声音 | 句长、口头禅配额、绝不说的话、按情境挑的对话示例 | — | 你 |
| 叙事身份 | 这一阵在意什么、怎么应对、一个关键场景、故事往哪走 | McAdams | 她自己写,要有证据 |
写法上有几条经验(都写在 docs/人格刻画.md 里):“毒舌”不是一个特质,要拆成“坦率高 + 顺从低 + 温柔高”——嘴上不让人、心里软;每条签名都要写“不会怎样”;写具体场合,别写口号。
1 | facets: |
运行时怎么用
- 稳定的部分放最前面:人格文件渲染成“# 你的人格”,放在人设正文最前,提示词前缀不变,能命中大模型服务的前缀缓存;
- 当下的部分放最后面:程序先认出 13 种情境(被叫到、被连着逗、没人接、被夸、被损、有人难过、问推荐、鸽了、被纠正、深夜、冒泡、新人、聊 AI),按“2 × 命中情境数 + 1 × 命中触发词数”给每条签名打分,挑前 1~3 条签名和 1~2 段对话示例,放在提示词最后、离生成最近的地方——这就是对抗人设漂移的做法。顺带一提,在这之前群聊其实根本没用到人设里的“# 对话示例”,这次才接上;
- 心情也是条件:CAPS 理论的原意是“if 情境 且 内部状态 then 行为”。她在群里的心情是两个数(愉悦度 valence、激活度 arousal,半衰期 120 分钟),程序据此认出“有点不服气 / 有点低落 / 心情很好”三种状态,人格文件可以给它们写专门的签名。同一个人,心情不同反应不同;
- 知识边界:人格文件里写她熟的、只知道个大概的(说话带“好像”“我记得”)、不懂的(说不懂、去查,别硬编)、不感兴趣的。依据是 Jones & Bergen 2025 的图灵测试研究:“承认不知道”是最像人的信号之一;
- 想法池(参考 Inner Thoughts,Liu et al. 2025):输出格式里多了一个
hold——想说但时机不对的一句先留着,最多 5 句、6 小时过期,聊到相关的或者群冷了再拿出来考虑,说出口了就划掉。
她会慢慢长大,但性格要你点头
每周回想一次“这一周的我”,每月整理一次“我是怎样的人”,按 McAdams 的第二、三层写:在意什么、怎么应对、一个带日期的关键场景、故事往哪走,每条都要给证据。她觉得性格该改一档时,只能记成一条建议,在小屋“她的日子 → 她是怎样的人”下面由你采纳或不改。
每周检查她有没有走样
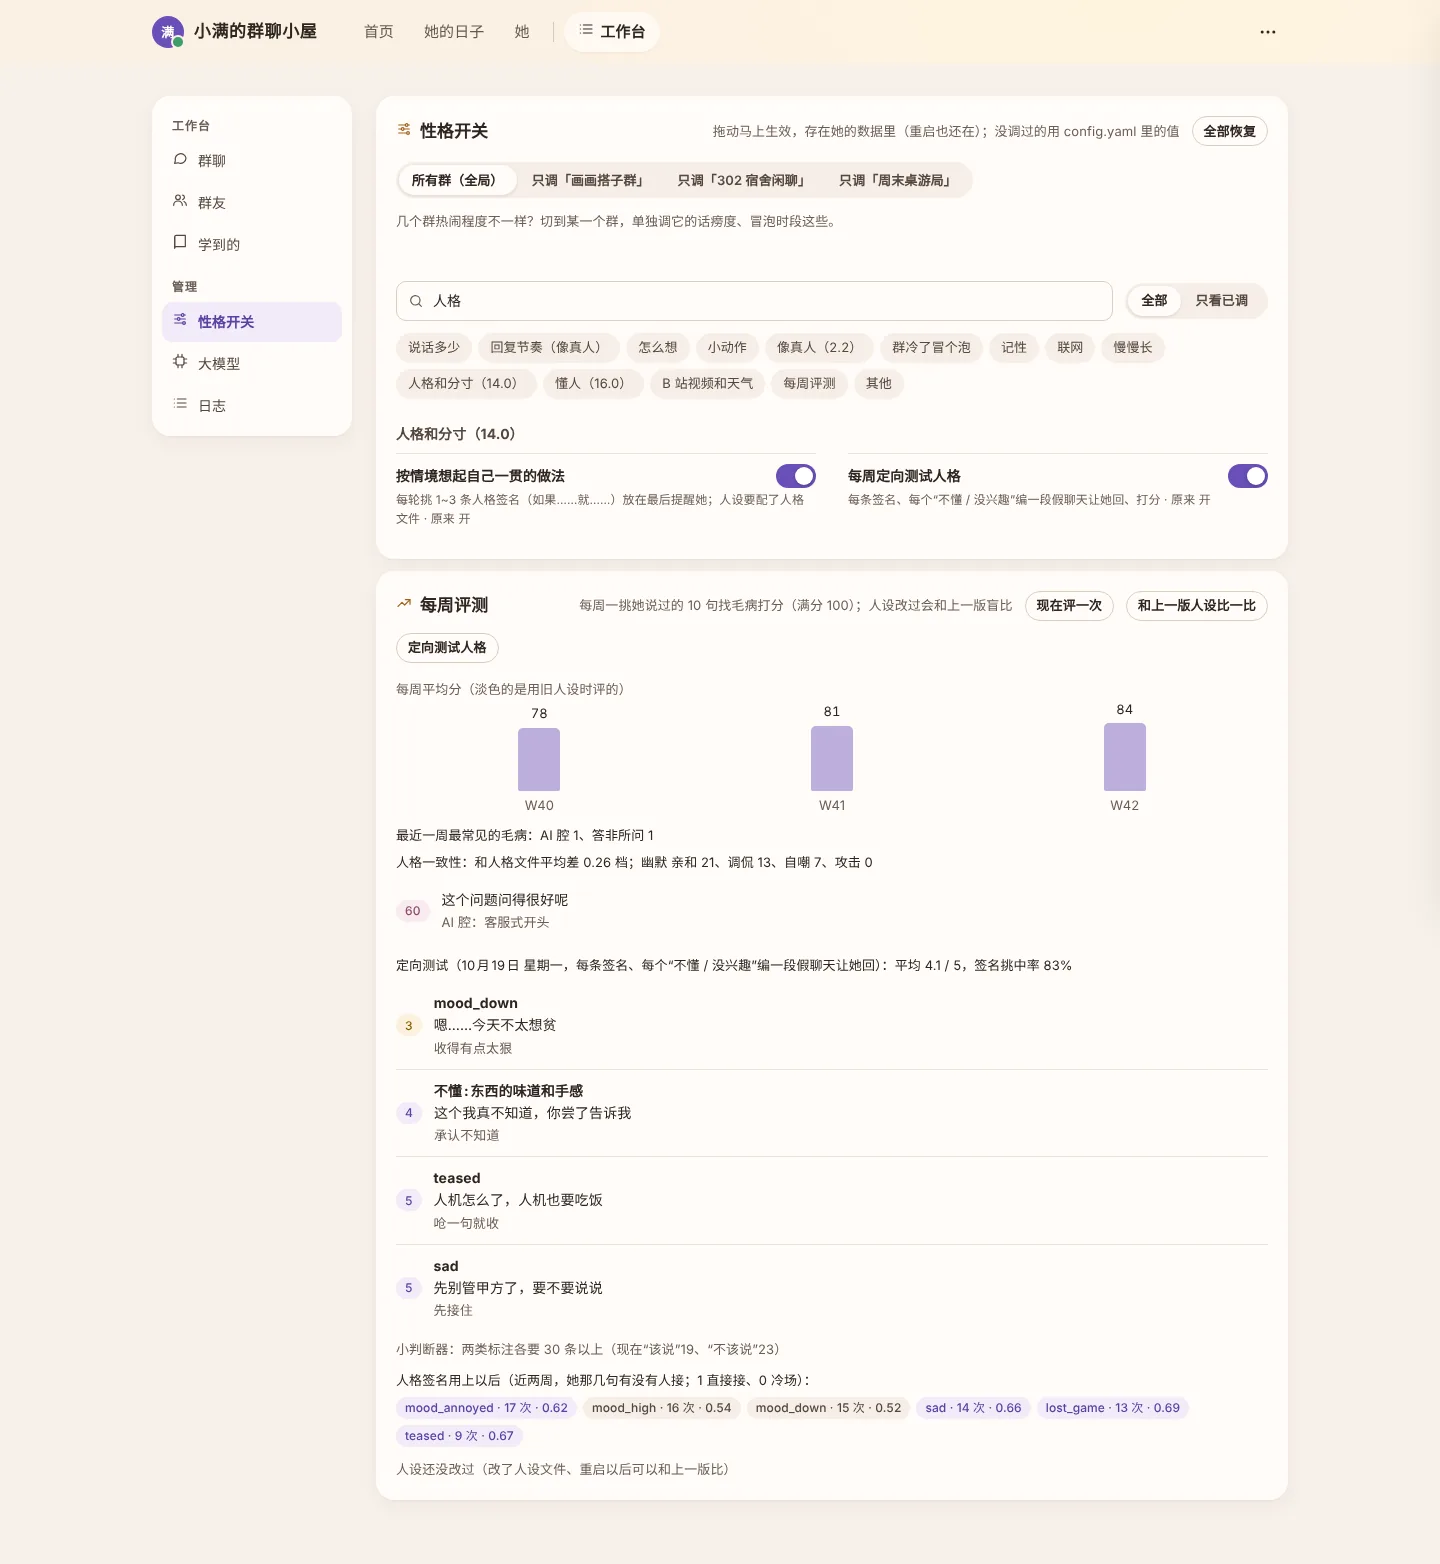
- 人格一致性:每周一,评测模型不看人设、只读她这一周说的话,给每个 facet 打 1~5 分,和人格文件里的目标比:平均差几档、哪一项跑偏了 ≥ 2 档、四种幽默各说了几句、有没有真伤人的话。第一次跑基线时,一个群平均差 0.25 档,另一个差 0.70 档(“愤怒敌意”高了 2 档),这就是要调的地方;
- 定向测试(参考 CharacterBench:稀疏的特质要专门出题测):给每条签名、每个“不懂 / 不感兴趣”的话题,让模型编一段会触发它的群聊,她回一句,评测模型按那条规则打分;同时看程序有没有挑中那条签名。场景编一次就缓存,周与周可比;
- 签名效果:每次用了哪几条签名都记下来,和“这句话后来有没有人接”对上。近两周用了 5 次以上、一半以上冷场的签名,每周自动变成一条“建议改写”。
四、私聊:怎样让有希“像个人”
像真人一样发消息
“像真人”首先体现在消息的形状上,而不是内容上。真人用手机聊天很少一次发一大段:会分成两三条,中间有停顿;会引用对方的某句话;偶尔打错字再补一句改正。
chat/delivery.py 在输出层模拟了这些细节:
- 模型用
|||分条,每条之间按typing_chars_per_sec: 6算停顿(单条最多 6 秒),QQ 上会显示“对方正在输入…”; - 可以引用你的话,按
typo_rate: 0.03偶尔打错一个字,再补一句“*正确的字”,说出口又后悔会撤回; - 表情包按优先级选:她从你这里学来的表情包 → QQ 小黄脸 → emoji;你发来的表情包会被理解成某种情绪存下来(17.1 起存之前会验证是不是一张完整的图)。
另一个容易被忽略的细节是等你说完:你连发几条时,companion 会等一会儿,把这几条合在一起理解。人设末尾的“对话示例”按话题挑 3 段给模型参考,只学语气和分条方式,照抄会被质检发现。
长期记忆:先查再合并
最朴素的做法是把对话摘要不断追加进数据库,很快就会出现两个问题:同一件事被反复记好几遍;新信息(“我换工作了”)和旧信息(“我在某公司上班”)同时存在。
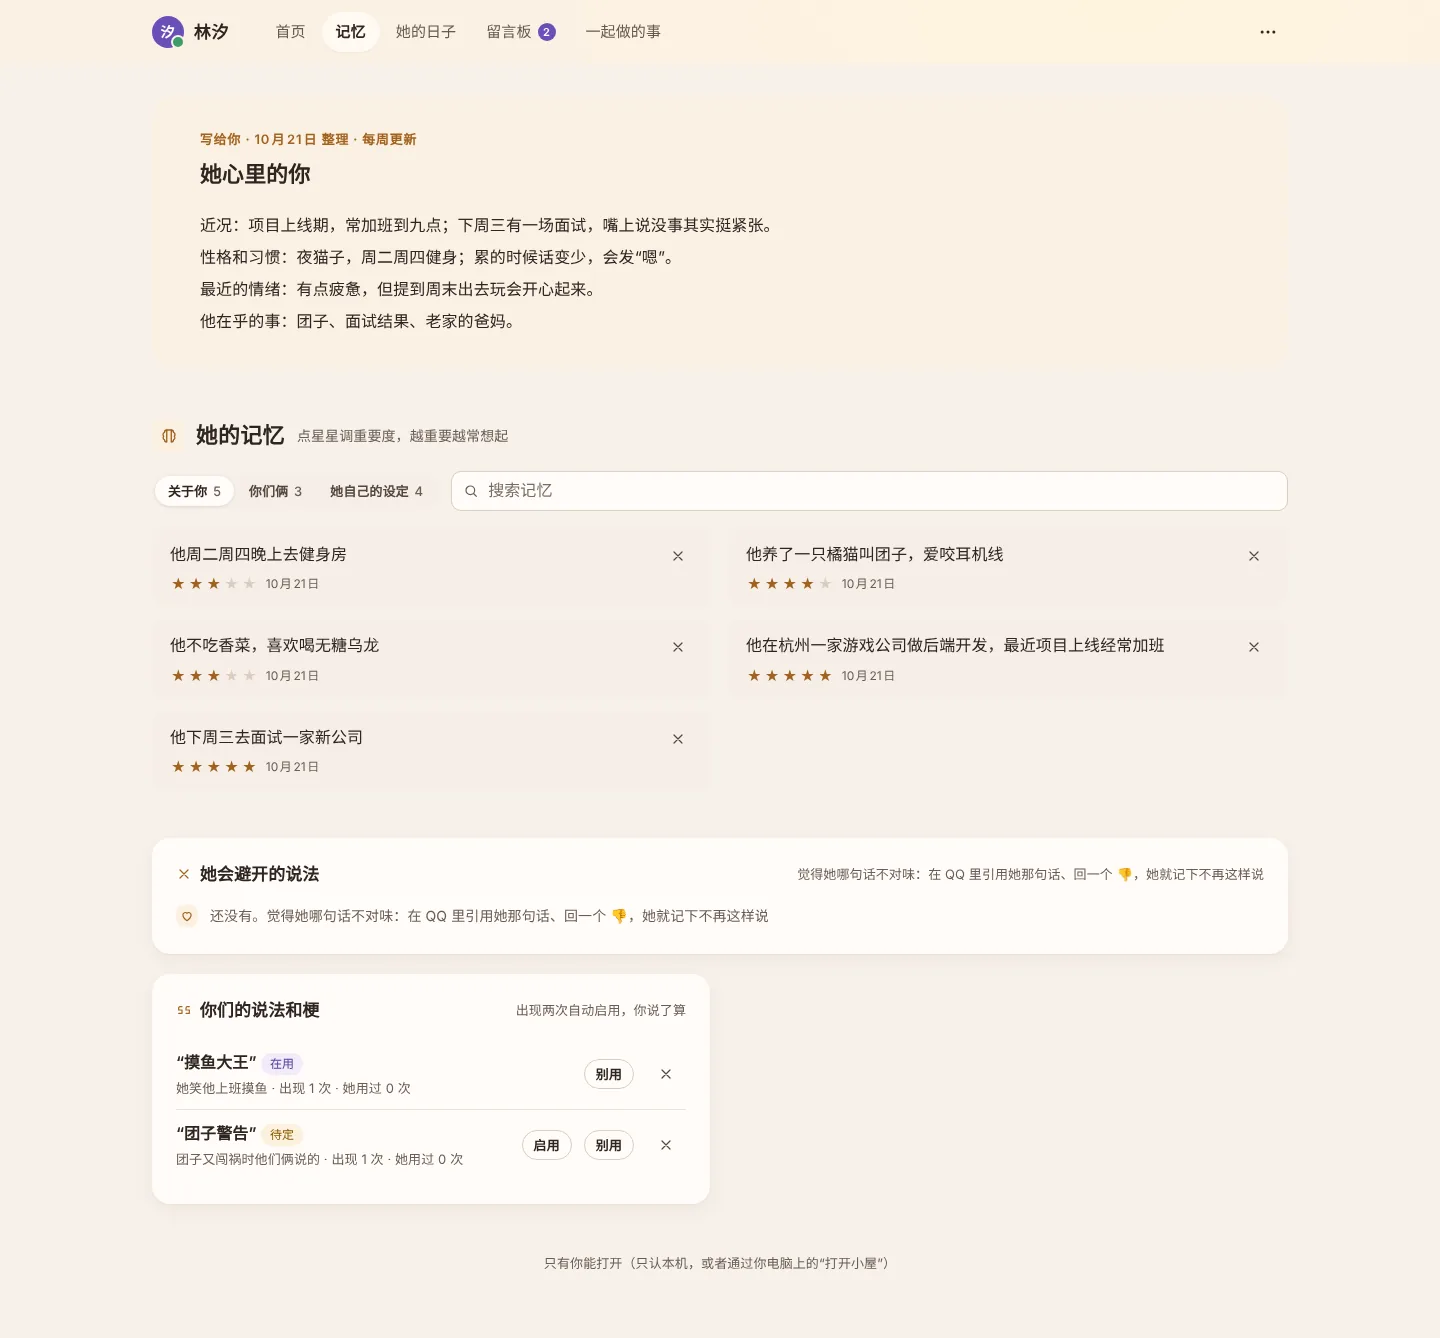
mind/memory.py 的整理流程是“先查再合并”:聊天告一段落后用模型抽取新事实;对每条新事实,先用向量在已有记忆里找“是不是同一件事”(余弦相似度 ≥ 0.92 视为同一件);是就更新旧条目,不是才新增。记忆分成三栏:关于你、你们俩、她自己的设定——她随口编出的设定(“我小时候学过三年钢琴”)也会记下来,之后前后一致。
检索是关键词 + 向量的混合方案(mind/retrieval.py):BM25(k1 = 1.4,b = 0.75)擅长命中人名、作品名;向量用 embed 用途接任意 OpenAI 兼容的 /embeddings(推荐硅基流动免费的 BAAI/bge-m3,不用装本地模型),相似度低于 0.35 的丢掉;两路用 RRF(k = 60)融合,向量接口不可用时自动退回纯关键词。
此外还有几种“软记忆”:每周整理一段“她心里的你”;还没聊完的事(14 天过期)、纪念日、你的作息从聊天里自动抽取;你引用她的话回一个 👎,这句话会记进“她会避开的说法”。
情绪与时间感
情绪不是一个“开心 / 难过”的标签,而是 mind/emotion.py 里四个 0~100 的数,各自被事件推动,再按半衰期指数衰减回基线:
| 维度 | 基线 | 半衰期 | 变化规律 |
|---|---|---|---|
| 开心 | 60 | 6 小时 | 聊得开心会升,过几个小时回落 |
| 想念 | 20 + 3.5 ×(离你上次说话的小时数 − 0.5) | 1.5 小时 | 你越久没来越高,你一说话就大幅下降 |
| 委屈 | 4 | 3 小时 | 被已读不回、被冷落时升高 |
| 疲惫 | 按小时查表 | 2 小时 | 跟着她自己的作息走,凌晨两三点最高 |
模型在回复里顺带写一个 [心情:…] 标记,程序把里面的词映射成数值(“开心、雀跃”开心 +12、委屈 −6;“委屈、吃醋”委屈 +12、开心 −10;“困、累”疲惫 +15)。这样情绪由模型“感受”、由程序“记账”,不会剧烈跳变。
有一个刻意的设计:好感度永远是满的(代码里就是一个常量 AFFECTION = 100)。我不希望 AI 伴侣用冷战、疏远来制造“攻略感”——她可以委屈、可以想你,但不会因为你忙了几天就不理你。
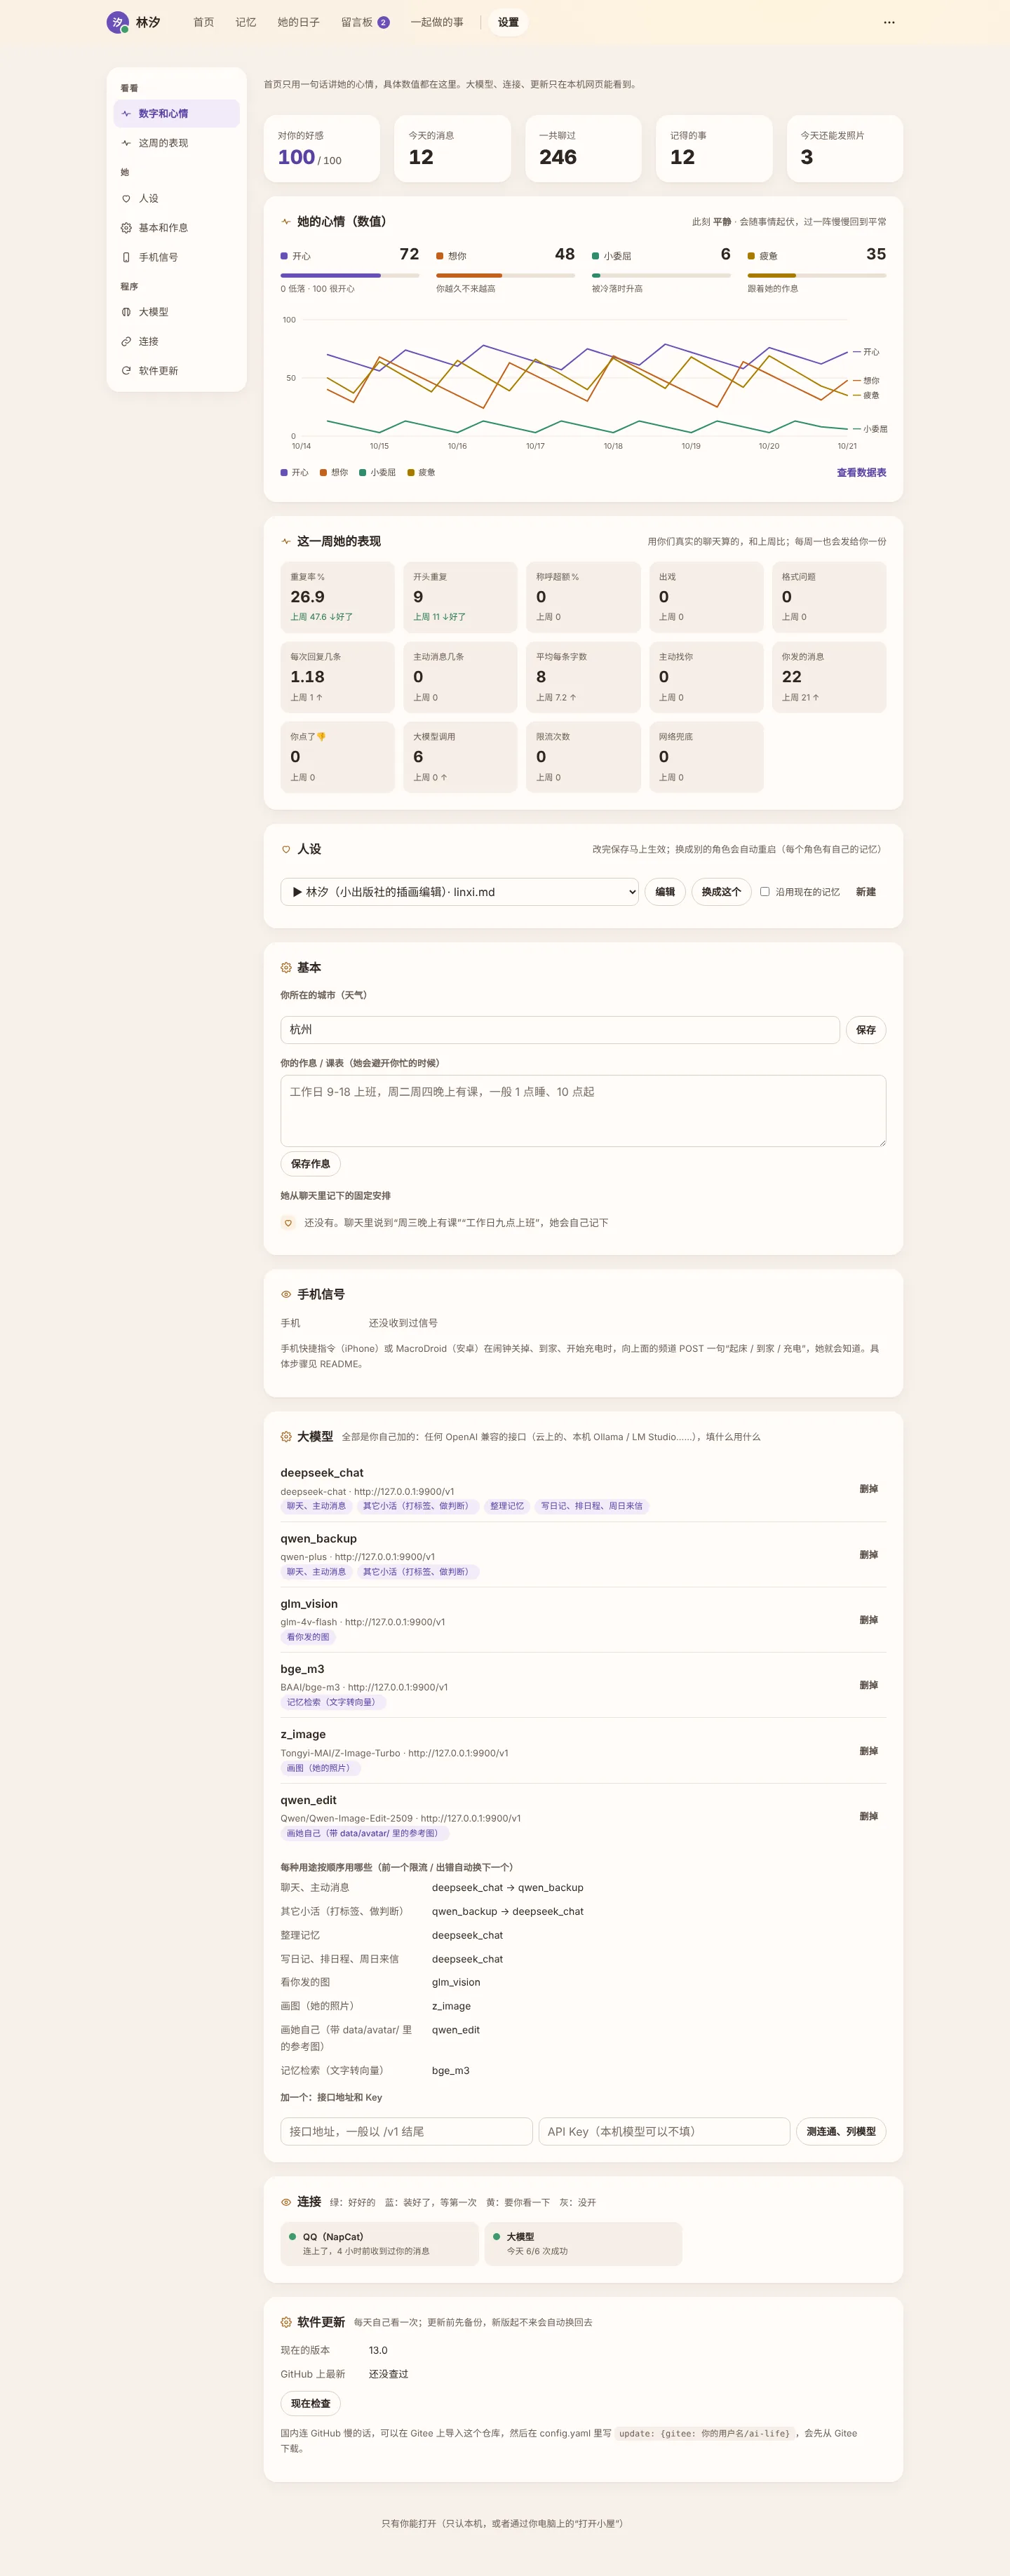
17.0 以后,小屋首页只用一句话讲她的心情(“心情很好,偶尔会想你在干嘛”),四个数值、7 天曲线和好感都挪进了“设置”——数字是给调试用的,不该是看她时的第一眼。
她自己的生活
- 作息与校历(
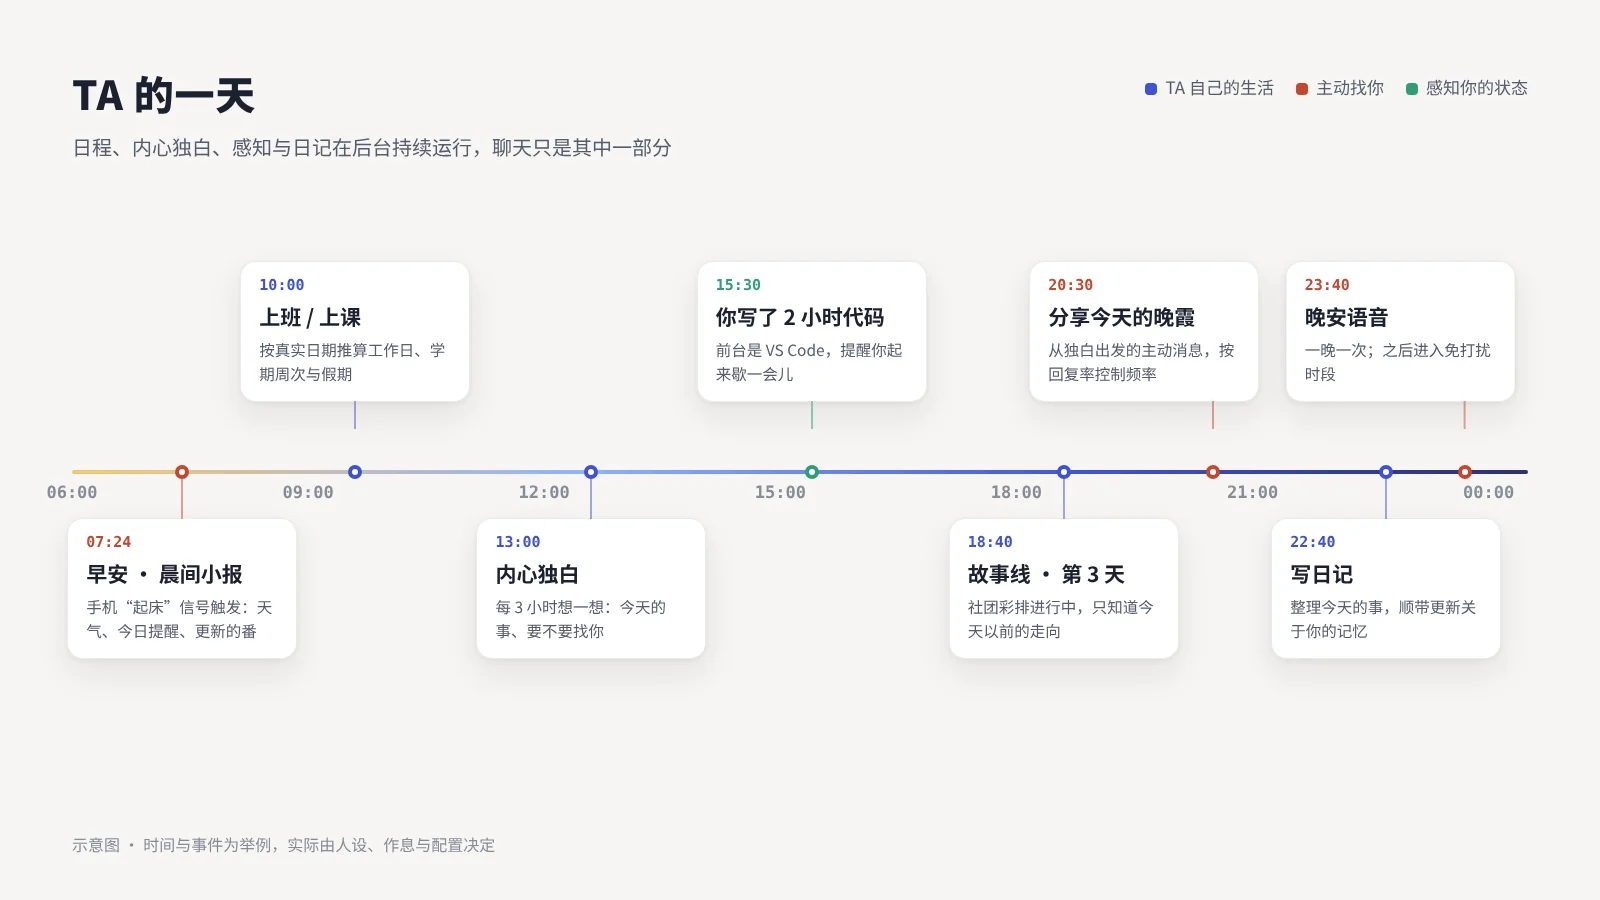
mind/rhythm.py):学生按真实日期推算学期、第几周、考试周和寒暑假;上班族按工作日上班。每学年升一级,每过一次生日长一岁。每天早上排好“今天的安排”,小屋首屏那句“林汐和编辑开选题会,会后一起吃面”就是从这里认出来的; - 身边的人(
mind/herworld.py):第一次运行时按人设固定好她的同事、朋友、家人,名字在日程、日记、聊天里保持一致; - 故事线:提前写好结局,只让她知道今天(
mind/story.py)。开线时模型一次写好全部步骤和结局存进数据库,但聊天和小屋里只放出今天及以前的部分。每天即兴编,事件之间没有连续性;把整条故事告诉她,她又会“剧透”自己的未来。预先规划、按日解锁,两全其美; - 长期目标:一两个持续几个月的目标(比如日语 N2),同样提前排好,有进展那天会想跟你分享;
- 内心独白(
mind/inner.py):清醒时每 3 小时“一个人想一想”,输出想法、心情、要不要找你、想说什么。决定找你时,主动消息就从这个想法出发; - 日记、来信、纪念册、回忆录:每晚日记,周日一封信,每月一份纪念册,每季度一本回忆录(只许用真实的聊天、日记和纪念日当材料,聊天少于 20 条就不写);
- 画她自己(17.0):配一个能带参考图的画图模型(
routes.image_ref,例如 Qwen-Image-Edit 一类),她发自拍时会照着家里data/avatar/的立绘画,长相前后一致;图上的中文由 Pillow 叠字,不让画图模型自己写字。
主动找你,但要有分寸
proactive/scheduler.py 每 10 分钟判断一次要不要找你,规则是一组明确的数字:
- 平均每天随机主动 2 次,你越久不说话,每小时多 3% 的概率;
- 两次至少隔 90 分钟,你 30 分钟内说过话就不插嘴;
- 一天最多 8 次(到点提醒和纪念日不算);连续 3 次没回就停;
- 免打扰 00:30~08:00;看你最近 14 天回主动消息的比例自动调频率。
主动消息也不是随机说话:早安带一份晨间小报(天气、提醒、纪念日、今天更新的番);内心独白里决定找你;手机快捷指令发来“起床 / 到家”信号(往一个私密的 ntfy 频道 POST 一句话),她就顺势说一句“到家啦”。程序关掉时她会发一句提前写好的道别;离开超过两小时再开机,会按当天的安排说说“刚才在干嘛”,错过的提醒合并成一次补上。
别越聊越像模板
    flowchart TD
  A["拼提示词<br/>列出最近说过的话、用过的开头、今天已分享的事"] --> B["模型生成回复"]
  B --> C{"质量检查<br/>和最近的话太像?开头重复?<br/>称呼超额?主动消息太长?"}
  C -->|"通过"| D["发送"]
  C -->|"有问题"| E["带着具体问题重写一次"]
  E --> F{"再次检查"}
  F -->|"通过"| D
  F -->|"仍有问题"| G["删掉有问题的几条(至少留一条)"]
  G --> D
mind/quality.py 用“生成前提醒 + 生成后检查”两道关处理,重写时原回复里定下的提醒、纪念日不会丢。还有一套人设回归评测:python run.py yuki eval 用一组固定对话在临时数据库里跑一遍,统计重复率、开头重复、称呼超额、出戏、回复长度,并和上次比较;完整模式还有 20 轮长对话和“隔开 50 条消息后还记不记得”的记忆测试。线上每周一出一份周报,在小屋设置页显示 14 项指标和上周的对比。
五、群聊:什么时候开口,比说什么更难
一条群消息走过的路
    flowchart LR
  A["ingest<br/>去重 · 脱敏 · 记录 · 复读检测"] --> B["speak<br/>等连发说完 · 算特征 · 认情境"]
  B --> C{"门控<br/>开口概率 vs 阈值"}
  C -->|"拿不准"| J["小判断器 / 便宜模型<br/>说 · 等 · 不"]
  J --> C
  C -->|"不说"| X["记进门控日志"]
  C -->|"说"| D["拼提示词<br/>人格在前 · 签名在后"]
  D --> E["大模型<br/>JSON 计划:说 / 不说 / 点表情<br/>回哪条 · 两种说法 · 想法池"]
  E --> F["质检 + 多选一"]
  F --> G["发送"]
  G --> H["5 分钟后看有没有人接<br/>每晚重新拟合门控"]
提示词按变化频率分层:system 部分按“几乎不变(人格、规矩)→ 每天才变(今天的安排、群笔记、关系网)→ 每批才变(在场的人的画像和相处经验)”排,user 部分放每次都变的聊天内容和当轮挑中的签名。这样前缀缓存能命中最长的一段,DeepSeek 一类接口上能省下不少钱。
门控:不调大模型,先算要不要说
群里的她最常犯的错不是说错话,而是话太多。chat/gate.py 在调用大模型之前,用纯计算决定这一批消息要不要开口:
- 开口概率:一个 logistic 回归,
logit = 偏置 + Σ 权重 × 特征。特征包括有没有叫她的名字、是不是 @ 了别人、有没有问号、是不是只有表情、最近 5 分钟她说话的占比等。初始权重一部分来自开源项目 MaiBot 用自己运行日志拟合的结果(偏置 −1.20、叫了名字 +1.59、@ 了别人 −1.12、有问号 +0.48、只有表情 −1.03……),其余是我加的; - 阈值不是固定的:把最近 1 小时这个群每批消息的开口概率从高到低累加,累加到“话痨度(默认 0.3)× 总和”时的那个概率就是当前阈值。也就是说,她大致只拿走一个群三成的“发言份额”,群越热闹门槛越高;
- 注意力和精力:她回了谁,那人的注意力 +0.4、其他人 −0.1,半衰期 5 分钟;她每主动说一次精力 −0.1,慢慢恢复;连续选“不说”时下次判断的间隔指数退避;
- 每天主动开口有预算:插话、冒泡、分享共用每天 40 次;同一个人 15 分钟内叫她 4 次以上,这一轮最多一条,也可以不回;
- 自己学:每次判断都写进门控日志,5 分钟后看有没有人接她的话,每晚用这些数据重新拟合权重。
拿不准时:问一下,再训练一个小判断器
门控离阈值只差一点的时候,最容易出错。13.0 加了“拿不准问一下”:这种时候问一个便宜模型,它只回一个字——说 / 等 / 不,“等”就等那个人再开口;每群每小时最多问 20 次,结果当作弱标签进每晚的重新拟合。
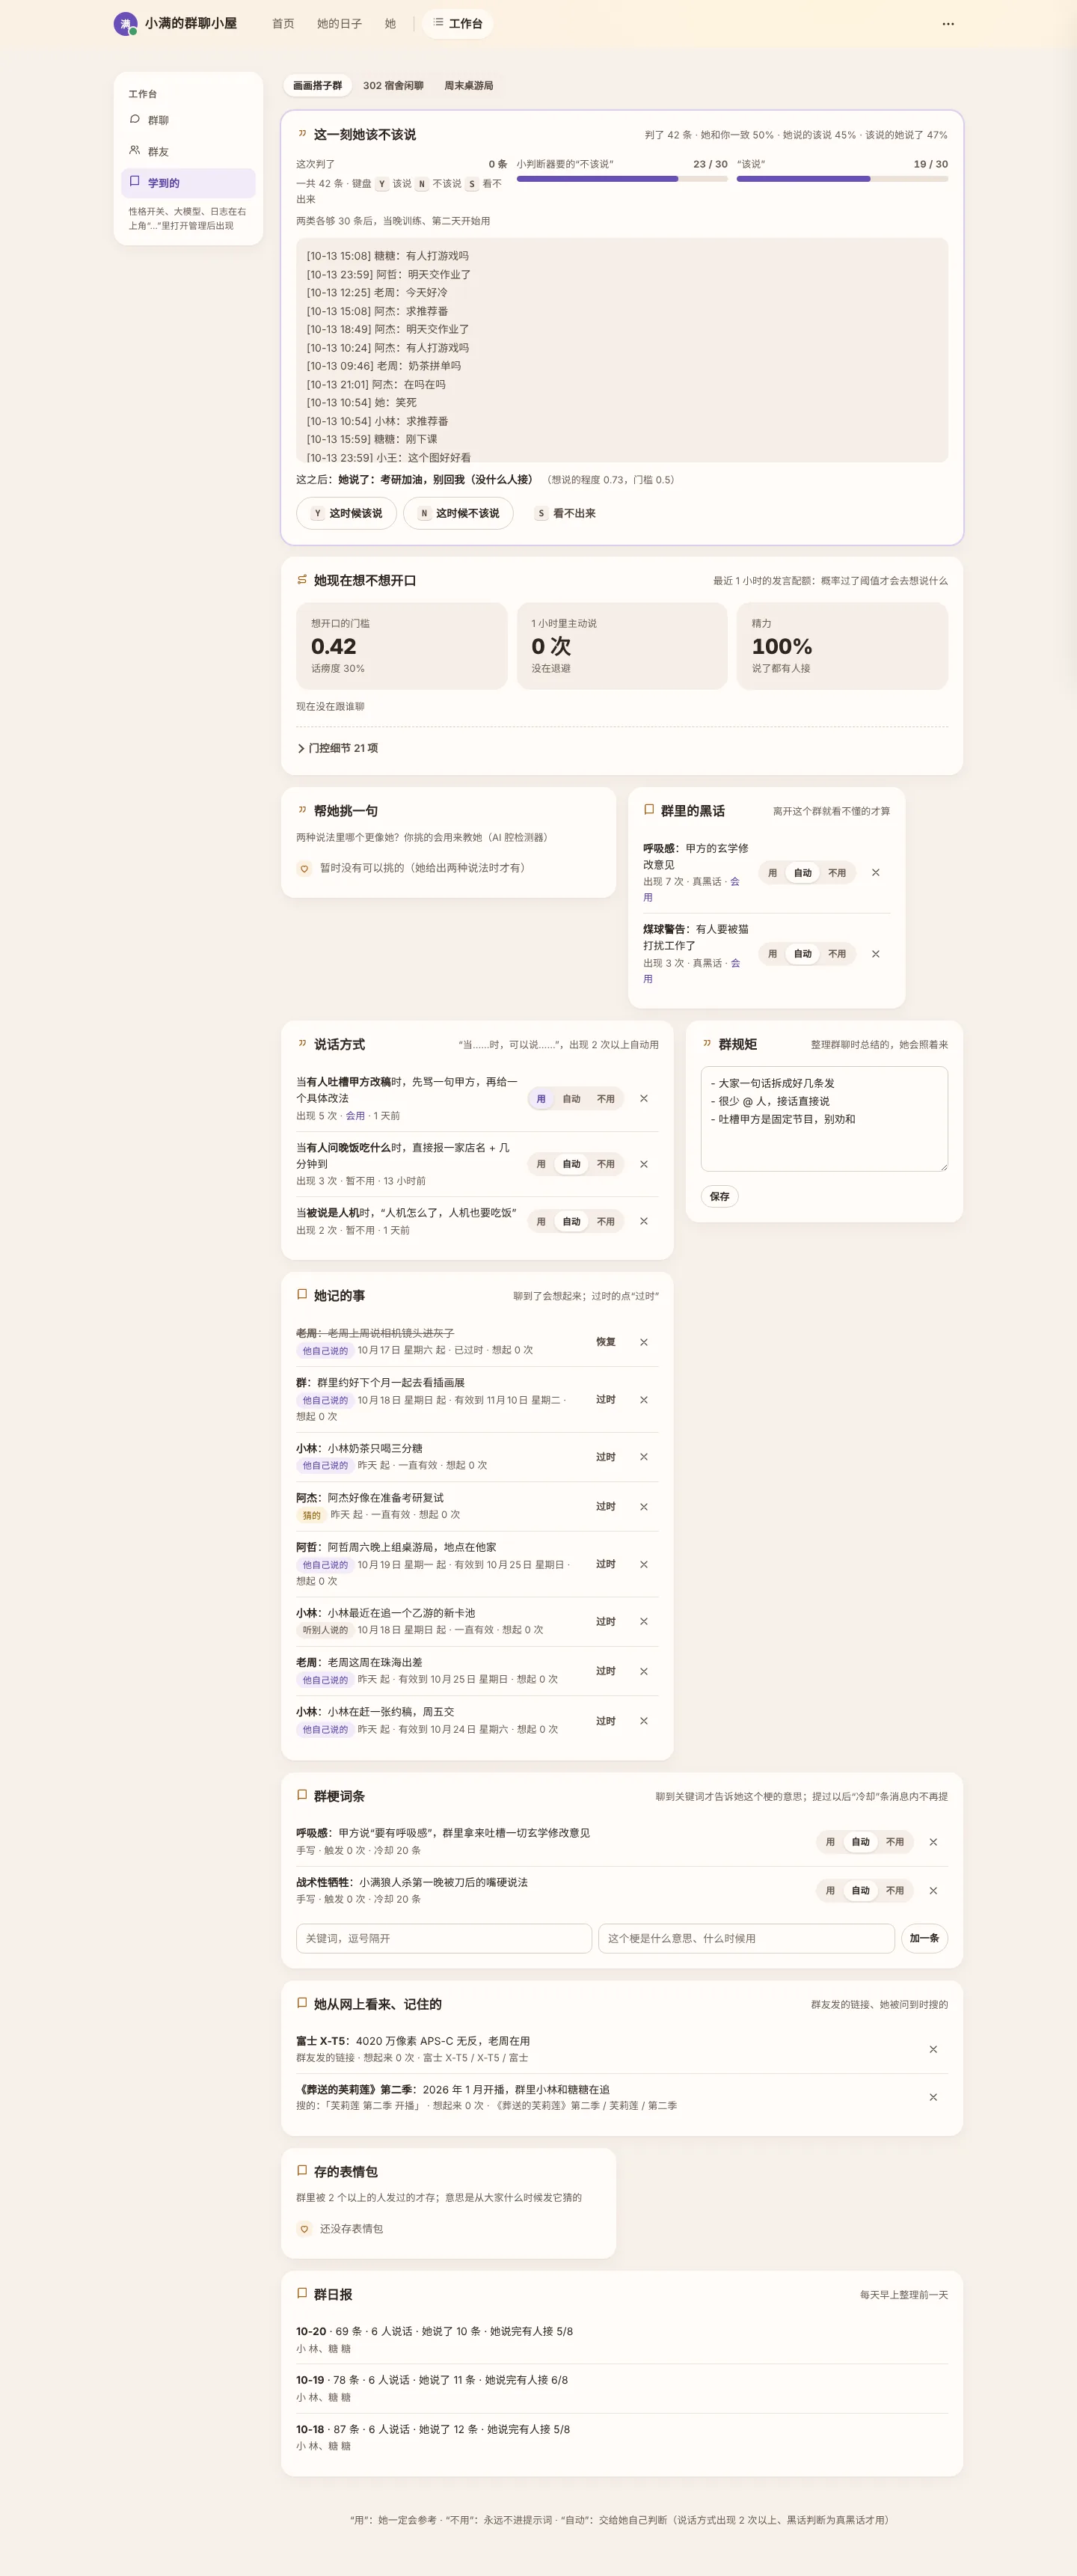
但最可靠的标签来自人。小屋“学到的”页最上面是这一刻她该不该说:程序优先挑“她说了没人接 / 问过模型 / 离阈值不到 0.1”的时刻,给你看那一刻之前的十来句和她后来说了什么,你按键盘 Y(该说)/ N(不该说)/ S(看不出来)。页面显示你的判断和她的一致率、精确率、召回率;这些标注在每晚重新拟合里权重最高。
16.0 再往前走一步(参考 DiscussLLM:先让小分类器判):两类标注各够 30 条,就用它们训练一个朴素贝叶斯小判断器——特征是那一刻之前 4 条消息的字二元组(区分她和群友、区分位置)加上门控特征,拉普拉斯平滑;随机留出 20% 测准确率,≥ 0.75 才启用;启用后,它有把握的时候(≥ 0.85 或 ≤ 0.15)就不再去问大模型。18.1 把标注进度改成实时计数,并写清楚“够数以后当晚训练、第二天开始用”。
像真人一样慢半拍
- 被叫到时 2~12 秒才“看到”,刷到想插话时 5~40 秒;
human_latency还会从这个群群友自己的回复间隔里抽样,群里大家回得慢,她也慢; - 她按自己的日程正在忙时被叫到,过一两分钟才偷空回一句。这里修过一个很典型的问题:以前等待期间群里每来一条新消息,她就把这批合起来从头再等,群越热闹回得越晚,最多能拖到 10 分钟。18.1 改成第一次被叫到时就定好回复的时刻,后来的消息只合进这一批一起回;
- 新消息来了会重新想一下(最多 2 次);聊天记录里隔了一小时以上会写“过了一个多小时”,她不会把几小时前的话当成刚说的;
- 半夜被叫到先记下,早上补一句“才看到”;两个人以上在复读时跟一句;不想说话时给某条消息点个表情。
懂每一个人
画像:每个群友一份,按群分开存(在 A 群知道的事不拿到 B 群说)。字段按和她自己的人格同一套分层:性格、说话风格、口头禅;他的反应(“被损时……;累了时……”,也就是他的 if-then);在意(他在群里图什么);看法、兴趣;带日期的近况和记得的事;称呼、群里关系、怎么聊、别碰的话题。每人多说 15 句就更新一次;只写有证据的,别人损他的话不当成他的性格;画像有历史版本,每人每群留 20 份,可以退回。
熟悉度和说话指纹:熟悉度是每晚结算、慢慢涨的分数,刚认识的人先客气,很熟的才互损;每晚还统计每个人 30 天的“说话指纹”:平均字数、表情包和图片比例、问句多少、常在几点出现。这些不靠模型猜。
关系网和相处经验(16.0,aigroup/chat/insight.py):
- 数两周里谁回复谁、谁 @ 谁、谁 90 秒内紧接着谁说话,按“2 × 回复 + 1.5 × @ + 0.5 × 紧接着”打分,得出“谁和谁常聊”,放进每天的背景里;
- 参考 LIFELONG-SOTOPIA 的经验总结:她对某个人说过的话里,哪些被接了(后续得分 ≥ 0.6)、哪些冷场了(≤ 0.2),每晚让模型总结成 3~5 条“他吃哪一套、什么会冷场”,和他说话时放进提示;
- 参考 FANToM(谁知道什么):一个人隔了 2 小时以上又出现,而这期间群里聊了不少,提示她“他不在的时候聊了这些,别默认他看过”;
- “今天的状态”由模型判断:关键词命中“累 / 崩溃 / 忙”以后,让便宜模型读他今天的话,判断真实状态(很好到很糟、忙不忙、依据),分得清“累死了哈哈哈”和真累。
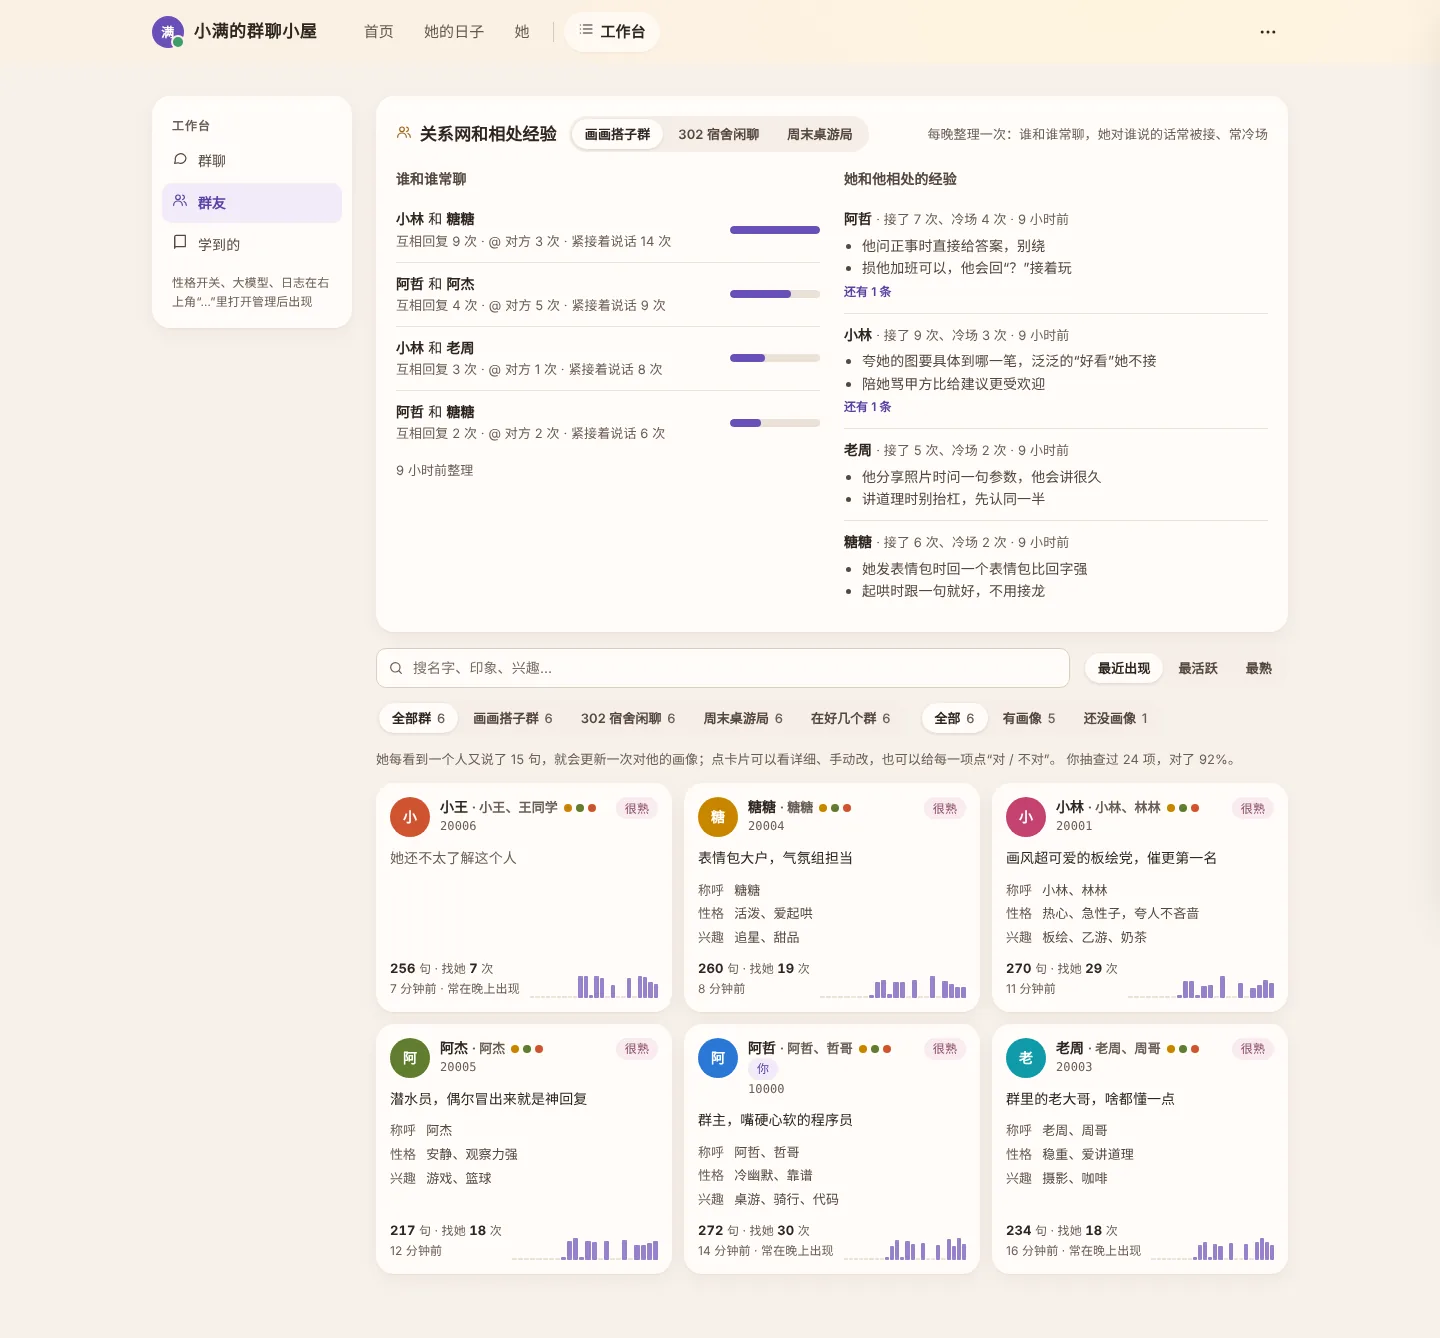
回话前先读心思:输出格式里的 think 先判断对方这句想要什么——逗她、认真问、求安慰、分享、吐槽还是随口一说,再决定怎么接。
她记的事分清是谁说的、到哪天为止(15.0):每条事实带来源——他自己说的 / 听别人说的 / 她猜的;开玩笑、互损、转述别人的事不算到他头上(依据 PersonaMem-v2:模型分不清“别人的偏好”和“用户自己的”)。“这周在赶论文”“明天考试”写到哪天为止,到点自动过期,不会过了好几天还问“论文赶完没”。猜的事只出现一次时先不拿来用,第二次出现才用。
你可以抽查:小屋群友页每个画像字段旁边有“对 / 不对”,统计每个字段的准确率;标了“不对”的字段,下次重写时会被要求按证据重写。
此外她还记得群里的事:群笔记和群梗(命中关键词时才告诉她意思);“周四开黑”“下周二面试”到点提醒、考前几小时打个气、事后问结果;群友生日送一张生日卡;有人说“在珠海出差”,她记下这几天他在哪,那边下大雨时提醒一句。
发出去之前的质检
aigroup/chat/quality.py 分硬规则和软规则。硬规则直接不发:思考过程外泄、说提示词、助手腔、做不到的媒介动作(“我刚拍了张照片发你”)、链接、Markdown 残留、碰了某人“别碰”的话题。软规则管“AI 腔”:“希望对你有帮助”、凡事列三点、滥用破折号……参考了 humanizer-zh、AnthroDial 和 Computational Turing Test 等研究。模型每次写两种说法,挑扣分少、条数少的那条。每周还会做一次她自己的风格审计:和群友比句长、口头禅、客服腔。
值得一提的是,现在两个群里的她都是公开的 AI(ai_open: true):大家都知道她是做出来的,所以她不再假装在上课、出门吃饭,“今天的安排”只写线上的事(刷比赛、查资料、整理小本本);“自称 AI”也不再扣分,只拦助手腔和说提示词。
拿真实群聊改一轮
微信群版刚接进两个真实的朋友群,第一个早上就暴露了一串问题:一进群就叫出别人的真名,说“听说你今天上最后一堂课”;被拉去“帮我上课”越说越真;问她中午吃什么,她反问“你们学校附近有啥好吃的”;同一个梗一个早上说了三遍;群友讨论她是怎么做出来的,她顺着说“代码还没传完呢”;有人没 @ 她、紧接着她的话追问,她当没看见。
修的时候我给自己定了一个要求:不针对这两个群打补丁,每一条都改成对任何群、任何人设都成立的规则:
| 问题 | 改成的通用规则 |
|---|---|
| 刚认识就说私事 | 事先导入过画像、但真正说上话不到 5 次的人算“刚认识”,他的近况和私事先不放进提示词;被问“怎么知道”就照实说是谁讲的 |
| 乱叫名字 | 每个群可以单独关“叫人名字”;没设的群看群友习惯,最近 300 句里互相叫名字不到 4% 就不叫、也不 @ |
| 没 @ 的追问不接 | 她刚说完,同一个人接着说“你……”或接了她的词,就当成在跟她说 |
| 一个梗连着玩 | 程序找出她这几个小时用过的“招牌说法”,提示词里列出来“这次别用”,质检也扣分 |
| 说幕后、反问 | 不说幕后的事;问什么就给个具体答案 |
| 重启丢 @ | 重启前 20 分钟里有人叫她、她还没回的,重启后补回 |
改完以后,我把那个早上出问题的几句话原样喂给新版本重放了一遍(不发群,只看她会怎么说;朋友的称呼换成了“某某”):
| 群友说 | 当时 | 现在 |
|---|---|---|
| @你是谁 | 昨晚被某某拉进来测试的那个……你是在验货吗 | 我叫小满,某某做的那个,先来打个招呼 |
| @你怎么知道我是谁 | 某某代码还没传完呢 | 某某跟我讲过你们,说群里最会带节奏的就是你 |
| @hello | 某某好,久仰久仰(叫了真名) | 来了来了,@一遍就够,我又不聋 |
| @你说我中午吃什么 | 你们学校附近有啥好吃的,我帮你挑 | 吃潮汕粿条吧 |
| 你小本本上都记啥了(没 @) | 没回 | 谁让我叫爷爷、谁约饭放鸽子……今晚开始一条条对账 |
| 感觉它不聪明(没 @) | 没回 | 人机能有我这么会记仇? |
这一轮最大的体会是:聊天记录比我自己想出来的测试用例有用得多。 为了让这件事可以重复做,仓库里有 replay(拿真实聊天回放)和 calibrate(看质检会不会误伤)两个工具。
进群前先做功课
“刚认识的人”的规则,配套的是一个进群前的准备流程(scripts\onboard.bat):导出群里以前的聊天记录(只读)→ 大模型整理成群笔记、群梗、每个常说话的人的画像草稿 → 你看过、删掉不想让她知道的 → 再灌进去。灌进去的人都算“事先听说的”,真正说上话以前,她不会把听来的私事说出来。
隐私做成机制,而不是一句承诺
13.0 把隐私从“注意一下”改成了程序里的机制:消息入库前就脱敏(手机号、身份证、银行卡、验证码、邮箱换成占位符);带正文的日志只写进她家里的日志文件;聊天记录按 keep_days 到期清理;forget-person / forget-group 能让她把某个人或某个群从所有表里忘掉,最后 VACUUM;仓库提交前还有一个隐私扫描钩子,防止私人内容进 git。
六、看得懂、听得懂、知道去查
- B 站视频真的“看”(15.0,
net/bili.py):有字幕读字幕,没字幕就取最低音质的音频做语音识别(只转前 20 分钟);再拿最低清晰度的视频流,用 ffmpeg 在“均匀撒点 + 弹幕最热闹的几段”各截一帧(默认 8 张),连同封面一次交给看图模型,写出“每个时间点画面上是什么”;总结时把声音和画面对上(“05:20 画面上是……这时候他在说……”)。只按需读那几秒,不下整个视频——服务器上实测一个 3 分半的 MV,13 秒看完。有人追问“3:12 那里”“画面上那个是谁”,就翻出那附近的原话和截到的画面; - 看图:图片按内容去重只看一次,分清截图 / 表情包 / 照片,摘出图上的字,写出把握,把握低时不当真。17.1 修过一个隐蔽的问题:下载图片时只读到了“已经到了的那一块”,大一点的图只存下开头几 KB,发出去是半张图、看图接口回 400;而看图和聊天用同一个模型时,这个 400 会让聊天模型冷却 60 秒,她那一分钟说不了话。现在读到头为止、发之前先认格式,图片本身的错误也不再让接口冷却;
- 听语音(群聊):QQ 语音转成 mp3 交给 SenseVoice 识别,连情绪和笑声一起译成“[语音 8 秒,带笑……]”;被要求时她也能用本地的 Kokoro 发语音(不克隆真人),每天有条数上限。有希这边仍然只用文字——声音一旦不像,出戏比文字严重得多;
- 不知道的先搜:问到作品、比赛、新闻这类她可能不知道的事,先查(Tavily 或国内搜索引擎),要点记成知识,常用到的慢慢变成她的兴趣;分享“刷到的”新闻只要最近 3 天的,程序会再对一遍发布日期,避免把旧闻当新闻;
- 链接:B 站、YouTube、公众号和普通网页先在后台点开读完再回你,只访问公网地址、最多读 2MB。
七、小屋:在聊天之外看见她
小屋是 aiohttp + 单页前端写的本机网页,两个页面共用一份 tokens.css。它只听 127.0.0.1,中间件校验 Host(防 DNS 重绑定),并拒绝跨站来源的请求;跑在服务器上时,在自己电脑上双击 scripts\open_home.bat,它用 SSH 隧道把三个小屋接到本机。
小屋的样子改过三次:14.1 换成安静的蓝白;17.0 换成“窗边日常”——首屏是她此刻和她的立绘;18.0 又换成现在暖色的“小屋”版。后两次都只改样子和排版,接口、数据库、提示词、群聊逻辑一个没动,原来的功能和字段一个没删。18.0 的几条设计规则:
- 一份 tokens:暖纸色底、奶油白卡片、深棕文字、蜂蜜色小图标;深色模式是暖棕的“台灯”色。字号、间距、圆角只用 tokens 里的几档,两个页面原来各自几百行样式全删了;
- 颜色跟着真实时间走:早上暖白(5~16 点)、傍晚玫瑰(16~21 点)、深夜深紫(21~5 点),每分钟对一次;
- 一行顶栏:头像、名字、页面和一个“…”菜单(深浅色、刷新、使用说明、管理),手机上页面放到底部一排;
- 首页只放“她”:有希首页按 12 列排“她的今天 / 一起的记忆 + 快到的日子 / 还没聊完的 + 她在想 / 故事线”,没有内容的卡片就不显示,空卡片也不占一整行;
- 群小屋分出“工作台”:首页只有今天的群——四个大数字和昨天比、消息图(今天 / 两周切换)、她的安排;群聊、群友、学到的、性格开关、大模型、日志放进带侧栏的工作台,更紧凑;
- 在 1440 / 1024 / 768 / 390 / 360 宽、深浅色、早上 / 傍晚 / 深夜都检查过,没有横向滚动。
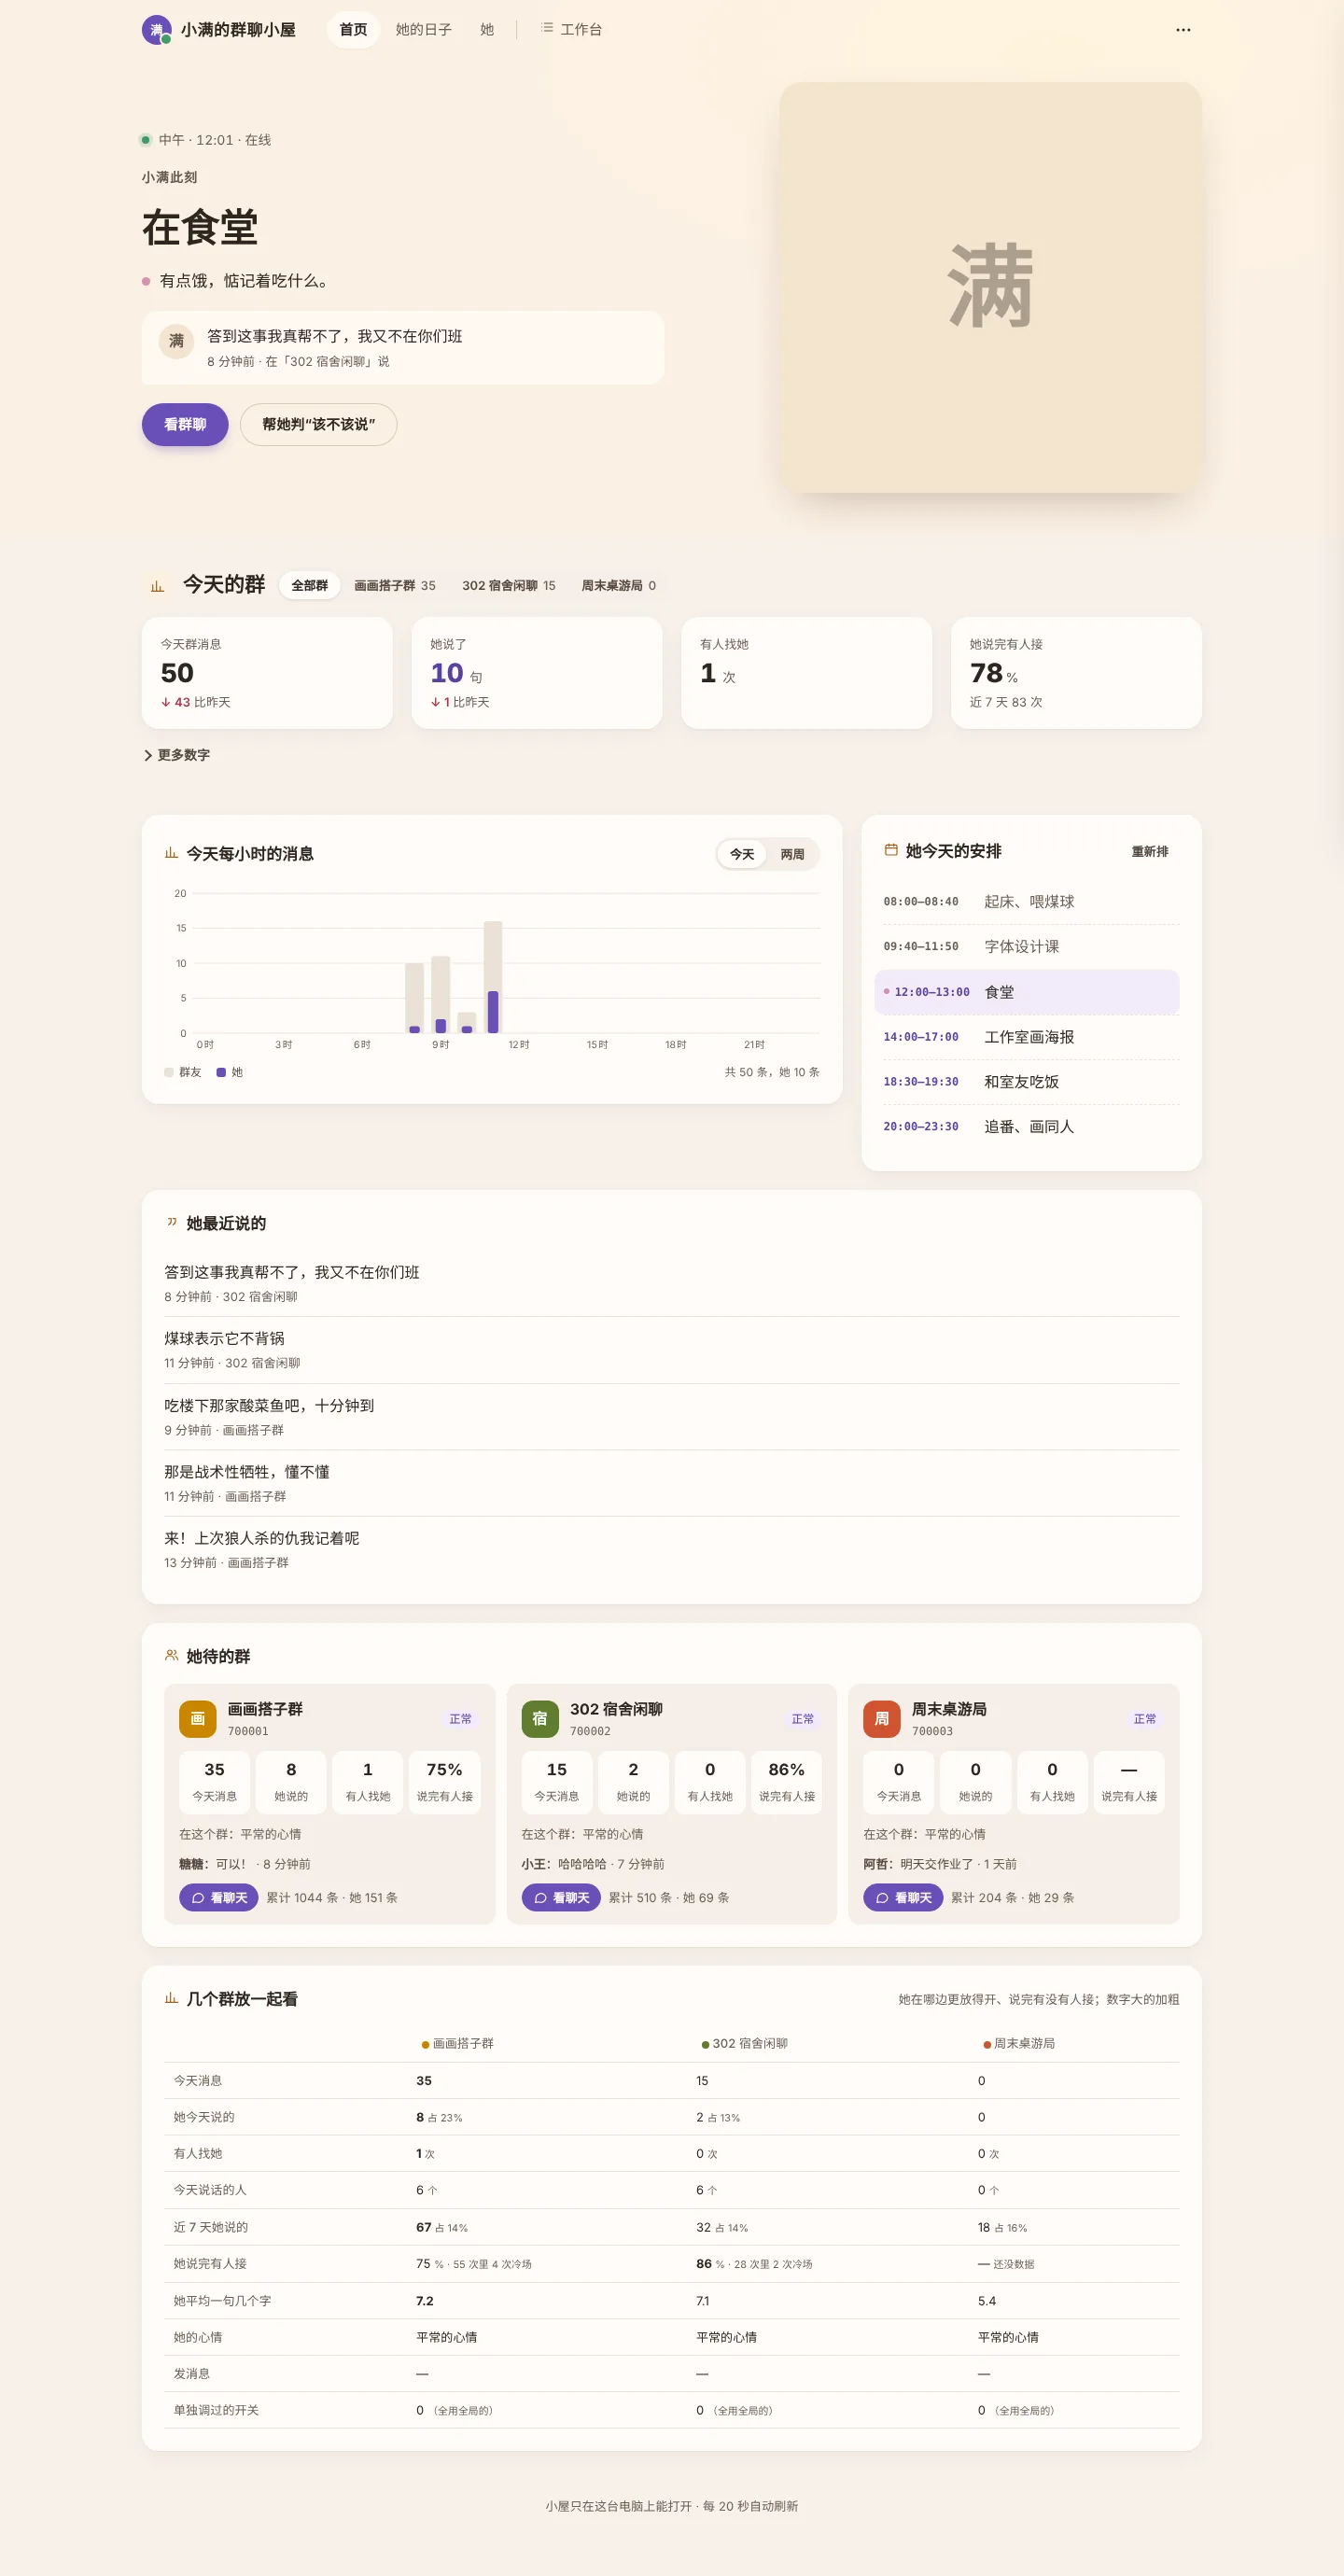
最常用的是群小屋的性格开关:插话概率、回复节奏、复读、点表情、冒泡、人格签名、懂人这些开关拖动马上生效,值存在她自己的数据库里,重启也在;可以只调某一个群;18.0 加了搜索、“只看已调”和分组目录。以前想让她话少一点要改 YAML 再重启,现在拖一下就能看出效果。
小屋顶上的连接状态只用四种颜色:绿是好好的,蓝是装好了在等第一次,黄是要你看一下,灰是没开。这条规矩写在 docs/DESIGN.md 里:整个界面里只有她本人是鲜活的,其余保持安静、清楚、诚实。
八、大模型:自己加,按用途分,花钱有上限
不内置任何接口。 程序里一个地址都不写,加模型的流程只有一条(小屋、命令行、配置向导共用一套代码):粘贴接口地址和 Key → 程序请求 /models 列出能用的模型,按名字猜是聊天、看图、画图还是向量模型 → 选一个,真的试聊一句、显示耗时(推理模型回复为空时,依次试几种常见的“关掉思考”参数)→ 选它用来干什么。
按用途路由(llm/roles.py):聊天、后台小活、整理记忆、夜里写日记、看图、画图、画她自己(带参考图)、记忆检索。每种用途排几个模型,前一个出错换下一个并让它冷却(限流 30 秒,一般错误 60 秒,额度耗尽 1 小时);后台类用途没配就跟着上一级,看图、画图、检索没配就干脆不做。仓库推荐的组合大致是:DeepSeek 聊天和看图(一张图不到 1 厘钱)、硅基流动的 bge-m3 做向量、Z-Image-Turbo 画日常、Qwen-Image-Edit 画她自己。
聊天优先:整理记忆、写日记这些后台任务一次只跑一个,你刚聊完的 25 秒内先让一让。所有模型都连不上时,她先回一句人设里写好的“信号好差,等我一下下”(不经过大模型),1、3、10 分钟后自动重试补上。
每天的花费上限(llm/budget.py):按接口返回的 token 估算人民币,画图按张算,三个角色共用一本账。到了上限,后台的活先停;聊天再多给一成,超了也停;第二天恢复。用到八成时在 QQ 上提醒。现在三个角色加起来每天 5 块钱以内。
九、部署:从一行命令到 24 小时在线
Windows 一键部署
1 | irm https://raw.githubusercontent.com/star031104/ai-life/main/get.ps1 | iex |
它会准备 Python 环境(有 conda 就用,没有就建 .venv,连 Python 都没有就用 winget 装)、用清华镜像装依赖和 ffmpeg、问你先配哪一个角色,然后打开配置向导。选了 QQ 的话,自动下载 NapCat、写好 WebSocket 和 token、弹出二维码,用小号扫一次码,之后自动登录。
装完双击 start.vbs,配好的角色全部在后台启动,每个角色一个托盘图标(粉色 L、绿色 G、微信绿 W)。程序意外退出 10 秒后自动重开;退出码 3 表示配置有问题,就不反复重开。托盘和程序之间不走端口,而是约定一个文件 data/tray_cmd:点“重启”时托盘往里写一个词,程序每秒看一眼,看到就自己收尾——有希还会先跟你道个别——再退出。
踩过的坑:最初每次开机都要扫码。查下来是程序把小号号码直接跟在 NapCat 后面,而 NapCat 只认 -q 号码,光秃秃的号码被悄悄忽略。原来的测试用的是一个假启动脚本,正好绕过了它——测试也换成了真实的 napcat.bat 内容。
微信是怎么接上的
微信没有官方机器人接口,aigroup/wechat/ 走的是“读本地数据库收消息 + 模拟操作发消息”:
- 收消息:微信本地库是 SQLCipher 4 加密的。程序只读地从微信进程内存里找候选密钥(Windows 用
ReadProcessMemory,Linux 读/proc/<pid>/mem),每个候选都先拿第 1 页的 HMAC 验过才用;之后只解密有变化的页,每秒看一眼; - 发消息:切到这个群的单独窗口 → 粘贴 → 回车 → 还原你原来的前台窗口和剪贴板;你在用键鼠就等一等。Linux 服务器上,微信跑在 Docker 的虚拟显示里,用
xdotool+xclip做同样的事。图片按图片格式放进剪贴板(17.1 以前是当文件粘贴,群里看到的是一个文件)。发完要在库里看到自己那条才算发出去。
搬上服务器
到 10.0 为止,ai-life 一直“住在你电脑上”。用久了发现最常见的场景是:你在外面用手机找她,家里的电脑正好关着。11.0 先做减法(删掉 Telegram、对公网开放的手机小屋、桌宠、电脑感知),再把三个角色搬上一台腾讯云轻量(2 核 4G、60G 盘、5M 带宽,Ubuntu 24.04 + Docker):
- 一份代码、一个
.venv、三个 systemd 服务(Restart=always,退出码 3 不重启); - NapCat 和 Linux 版微信跑在 Docker 里;两个 NapCat 容器要各自固定 machine-id、主机名和 MAC,否则会互相把对方踢下线;
- 所有端口只绑
127.0.0.1,对外只开 SSH; - 小管家
deploy/server/ops.py用 cron 每 5 分钟看一次门、汇总花费,每天备份、出日报;QQ 被踢下线时用存好的密码重启 NapCat,要短信验证就在 QQ 上提醒。
三个角色、两个 NapCat、一个微信全部起来后,内存用了约 1.2 GB(总共 3.6 GB),平均负载 0.3 左右,硬盘不到 10 GB,大头是 Docker 镜像。大模型都走云上接口,服务器本身不做推理。
自动更新与自检
core/update.py 每天看一次 GitHub 上的版本号,有新版本就在小屋亮黄点,你点“更新”才装。下载的 zip 要过四项检查(CRC、版本号、关键文件、没有奇怪的路径),任何一项不对就一个文件都不动;config*.yaml、.env、data/ 和你已有的人设永远不碰;新版跑满两分钟才算成功,连续两次刚启动就退出就自动换回旧版。
| 命令 | 做什么 |
|---|---|
python run.py yuki selftest |
不联网、不碰真实数据,用假模型把核心流程跑一遍,并检查新版本能否打开你数据库的副本 |
python run.py qq check / wxdiag |
群聊体检:接口、NapCat / 微信、数据库 |
python run.py yuki eval |
有希的人设回归评测 |
replay / calibrate |
群聊回放和质检校准 |
/diag(在 QQ 私聊里发) |
一键检查每个接口、QQ、数据库和备份 |
1 | ai-life 13.0 离线自检 |
十、版本历程
| 版本 | 做了什么 |
|---|---|
| 9.0 | 删掉语音条、打电话、桌宠说话(近千行代码、四百多 MB 本地模型);Windows 一键部署 |
| 10.0 | 不加功能的重构:五十多个平铺文件拆成分层包;不再内置任何大模型地址 |
| 11.0 | 删掉 Telegram、手机小屋、桌宠、电脑感知,三个角色搬上服务器 |
| 12.0 | 三个仓库合成一个;照着真实群聊把规则改了一轮 |
| 13.0 | 修好“群聊事实表一直是空的”这个大 bug;向量改接 /embeddings;门控拿不准时问一下;看图、听语音、画她自己;隐私做成机制 |
| 14.0 | 结构化人格(六层)、情境签名放在提示词最后、每周人格一致性评测 |
| 15.0 | B 站视频截画面“看”;知识边界;想法池;记忆分来源和有效期 |
| 16.0 | 心情改变反应;关系网、相处经验、谁刚回来;画像抽查;定向测试;朴素贝叶斯小判断器 |
| 17.0 | 小屋“窗边日常”版:首屏是她此刻和立绘、颜色跟着时间走;有希也能带参考图画自己 |
| 17.1 / 17.2 | 图片下载只存半张的问题;微信发图按图片发;“发张照片”真的发照片 |
| 18.0 | 小屋暖色“小屋”版:一行顶栏、空卡片不占地方、群小屋分出工作台 |
| 18.1 | 被叫到不再越等越久;“该不该说”的进度实时计数 |
回头看,ai-life 有好几次是靠删东西变好的:9.0 删语音,11.0 删 Telegram、桌宠和电脑感知(每 30 秒看一眼你的前台程序,这本来就是最越界的功能),17.0 把心情数值和连接状态从首页挪走,只留一句话。少一个功能,就少一类要操心的事;首页少一个数字,她就更像一个人而不是一块仪表盘。
十一、边界:AI 伴侣不能替代真实的人
陪伴类产品天然带着风险,所以 ai-life 在内容上写了明确的准则:
- 角色都是成年人,不写露骨内容;
- 不用冷战、威胁或让人愧疚的方式绑住你(这也是好感度恒满的原因);
- 你连着两天情绪低落,她会收起捉弄和小脾气,多陪你、多听你说;
- 你说起伤害自己的念头时,她会认真对待,并鼓励你找身边信任的人或专业帮助。
AI 伴侣可以让人在某些时刻感到被惦记,但它不能代替现实中的人际关系和专业支持。这句话写在 README 里,也是我做这个项目时一直提醒自己的。
十二、总结
ai-life 里真正花时间的不是“接一个大模型”,而是围绕它补齐一个“人”需要的东西:性格、时间、生活、记忆、情绪,以及对每一个人的理解。很多功能单看都很小——只解锁到今天的故事线、只拿三成发言份额的阈值、放在提示词最后的那一两条签名、“他不在的时候聊了这些”的一句提醒——但正是这些细节决定了它是工具还是一个“在场的人”。
另一半是工程上的克制和诚实:在不稳定的接口上做路由、冷却和花费上限;用离线自检、回归评测和每周的人格一致性评测保证每次更新不会让她“变了个人”;把隐私做成入库即脱敏、可以让她忘掉某个人的机制。
还有一半是真实的聊天和你自己的判断:规则写得再全,也要放进真的群里跑一个早上才知道漏了什么;小屋里你按下的每一个 Y 和 N,最后都会变成她判断“这时候该不该说话”的依据。
如果你也想拥有一个有自己性格和日子的 AI 伙伴,欢迎试试 ai-life。更详细的说明见仓库的 docs/人格刻画.md、docs/小屋.md、docs/YUKI.md、docs/GROUP_QQ.md、docs/GROUP_WECHAT.md,也欢迎提 Issue 和 PR。