现在的模型已经能很快生成大纲和文案,但一份真正要交给老师、客户或管理层的演示,不只是一组文字卡片。它必须回答:这个数字从哪里来?为什么这一页用图表而不是列表?改一页会不会动到别的页?导出的 PowerPoint 还能不能编辑?任务中断后能不能继续?
映章是我为这些问题做的一套本地优先的 AI 演示工作台:读懂 PDF、Word、Excel、PPT 材料,规划叙事,逐页生成多个候选,自动做质量检查,最后交付 HTML、PDF、原生可编辑 PPTX 和讲解视频。
映章的目标不是替人“按一下生成 PPT”,而是把演示生产拆成一条可追踪、可检查、可恢复的流水线:模型负责提议,确定性程序守住事实与版式的底线。
这篇文章按“能做什么 → 一次完整流程 → 每一块怎么实现 → 开发中踩过的坑”的顺序写。截图来自一次真实运行:材料是一家虚构公司“青禾仓配”的 Word 运营报告和 Excel 季度指标表,模型接的是本机一个返回预写内容的模拟接口,界面、规则校验、渲染、评分和导出全部是映章自己的真实结果。
项目地址:GitHub · yingzhang-ai-ppt
| 项目 | 现状 |
|---|---|
| 当前版本 | v0.2.0(首个公开版本 v0.1.0 发布于 2026-09-13) |
| 技术栈 | FastAPI + SQLAlchemy + SQLite(WAL)· React 19 + TypeScript · Playwright Chromium · PptxGenJS + python-pptx |
| 代码 | 后端 Python 约 2.4 万行,前端约 5.6 千行,演示引擎约 3.2 千行 |
| 测试 | 后端 300 项、演示引擎 61 项、前端 25 项全部通过;四类基准门禁通过 |
| 跨格式保真度 | 导出的 PPTX 经 LibreOffice 渲染后与 HTML 预览逐页比对,平均 98.7–99.5(旧导出器 81.6–86.9) |
| 交付格式 | HTML、PDF、原生可编辑 PPTX、讲解视频(MP4 + SRT) |
一、为什么做映章
多数 AI PPT 工具擅长“一句话出十页”。可一旦材料里有真实数字、口径限制和交付要求,问题就来了。
| 常见 AI PPT 生成器 | 映章 | |
|---|---|---|
| 事实来源 | 模型自由发挥,数字难追溯 | 数字、结论、表格绑定到原文位置,材料里没有的数字会被拦截 |
| 版式决策 | 一套模板从头用到尾 | 按页面角色和数据形态选版式,每页多个真实渲染的候选 |
| 交付格式 | 常是图片或难编辑的文本框 | 图表、表格、流程图输出为 PowerPoint 原生对象 |
| 长任务 | 中断后从头再来 | 有界节点 + 持久化快照,可取消、可恢复、单页重做 |
| 质量 | 看起来没问题就交付 | 溢出、重叠、对比度、证据覆盖统一检查,正式导出前必须通过门禁 |
| 数据 | 上传到第三方平台 | 项目、凭据和个人偏好默认只留在本机 |
二、功能一览
- 新建演示:一句话要求 + 可选的多份材料,15 类演示类型(毕业答辩、商业计划、经营复盘、产品发布、教学课件……),6~60 页;
- 模型配置:填任意 OpenAI 兼容接口的地址和 Key,自动发现模型、实测验证;针对 10B 以内的小模型有专门的分段策略;
- 材料解析:PDF、Word、Excel/CSV、PPTX、Markdown、网页、图片,按章节、表格、图注结构化,可逐章核对;
- 证据约束:每页绑定来源,模型写出材料里不存在的数字会被拦下;
- 分步确认:可以先确认大纲、再确认 3 页代表样张、最后生成全稿;
- 多候选版式:每页 3~6 个真实渲染的候选,带分数,选中后锁定;
- 编辑:对象级编辑、只重做当前页、框选局部修改,每次保存生成新版本,可对比和回滚;
- 质量门禁:五维专业审计 + 视觉反思 + 无障碍检查,正式导出前必须通过;
- 研究级评测:PPTEval 式内容 / 设计 / 连贯三维评分,“只凭页面能答对多少材料问题”的信息保留测验;
- 交付:HTML、PDF、原生可编辑 PPTX(8 类原生图表、原生表格、带出处的演讲备注)、讲解视频;
- Agent 集成:无 SDK 依赖的 MCP 服务器和 Agent Skill,可以让 Claude Code、Codex、Cursor 直接调用;
- 部署:Windows 双击
启动映章.exe,或者 Docker 一键起。
三、一次完整的使用流程
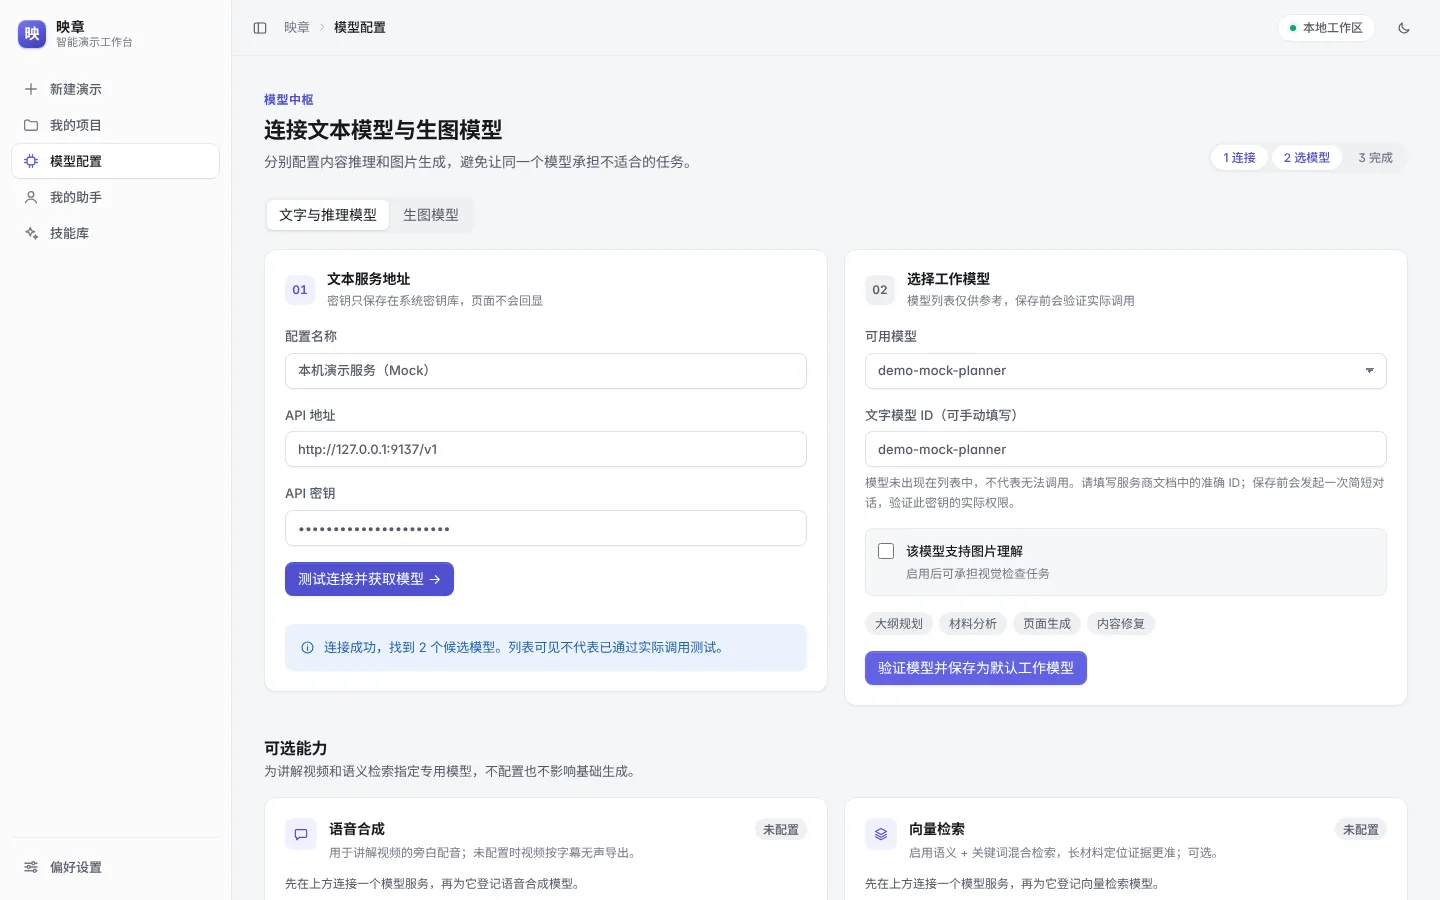
配模型
在“模型配置”里填接口地址和 Key,点“测试连接并获取模型”,程序请求 GET {base}/models 列出能用的模型;点“验证模型并保存”,它会真的发一次“回复 OK”的短请求,验证通过才保存。所以列表里没出现的模型 ID 也能手动填,能跑通就能用。保存后规划、材料分析、页面编写、修复、研究五个角色自动指向这个模型;语音合成和向量检索是可选能力,单独配置。Key 存进系统 keyring,不进数据库。
新建演示、上传材料
界面上只有标题、“你希望怎样制作”、材料、演示类型和页数;受众、时长、目标、语气、品牌和视觉方案都折叠在“受众、语气与视觉”里,不填也能开始。
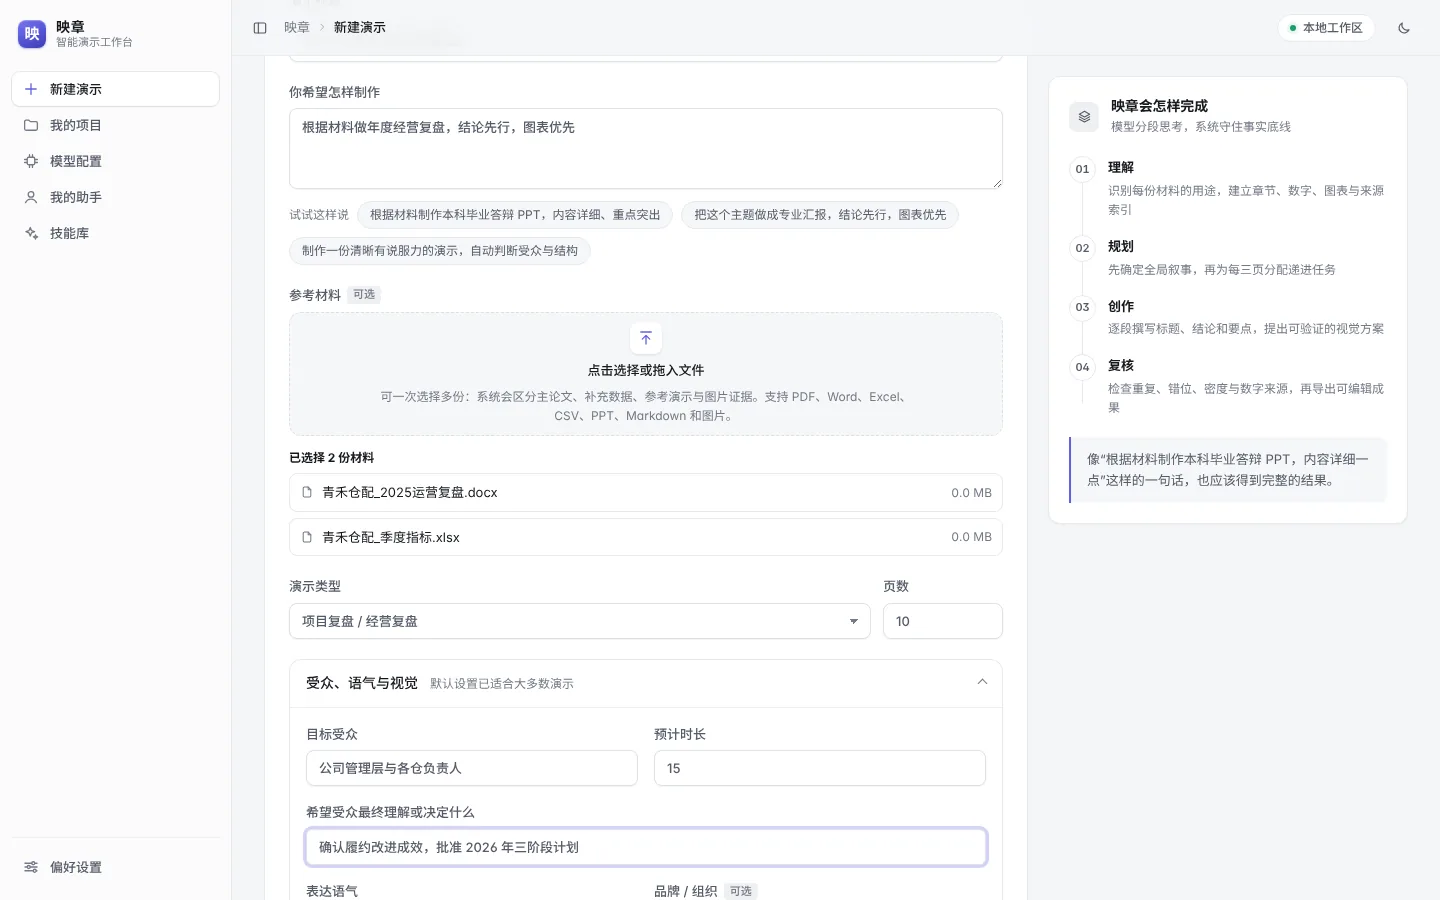
这次的输入:标题“青禾仓配年度运营复盘”,要求“根据材料做年度经营复盘,结论先行,图表优先”,上传一份 docx 和一份 xlsx,类型选“项目复盘 / 经营复盘”,10 页,受众“公司管理层与各仓负责人”,视觉方案“数据咨询”。
点“开始智能生成”后,后台依次完成:解析两份材料 → 建立全稿策略 → 分 3 批规划(每批 4 页)→ 规则校验 → 每页 4~6 个候选渲染打分 → 选版 → 视觉复核 → 组装。整个过程大约半分钟(模拟接口是秒回的,这个时间基本是浏览器渲染耗时)。
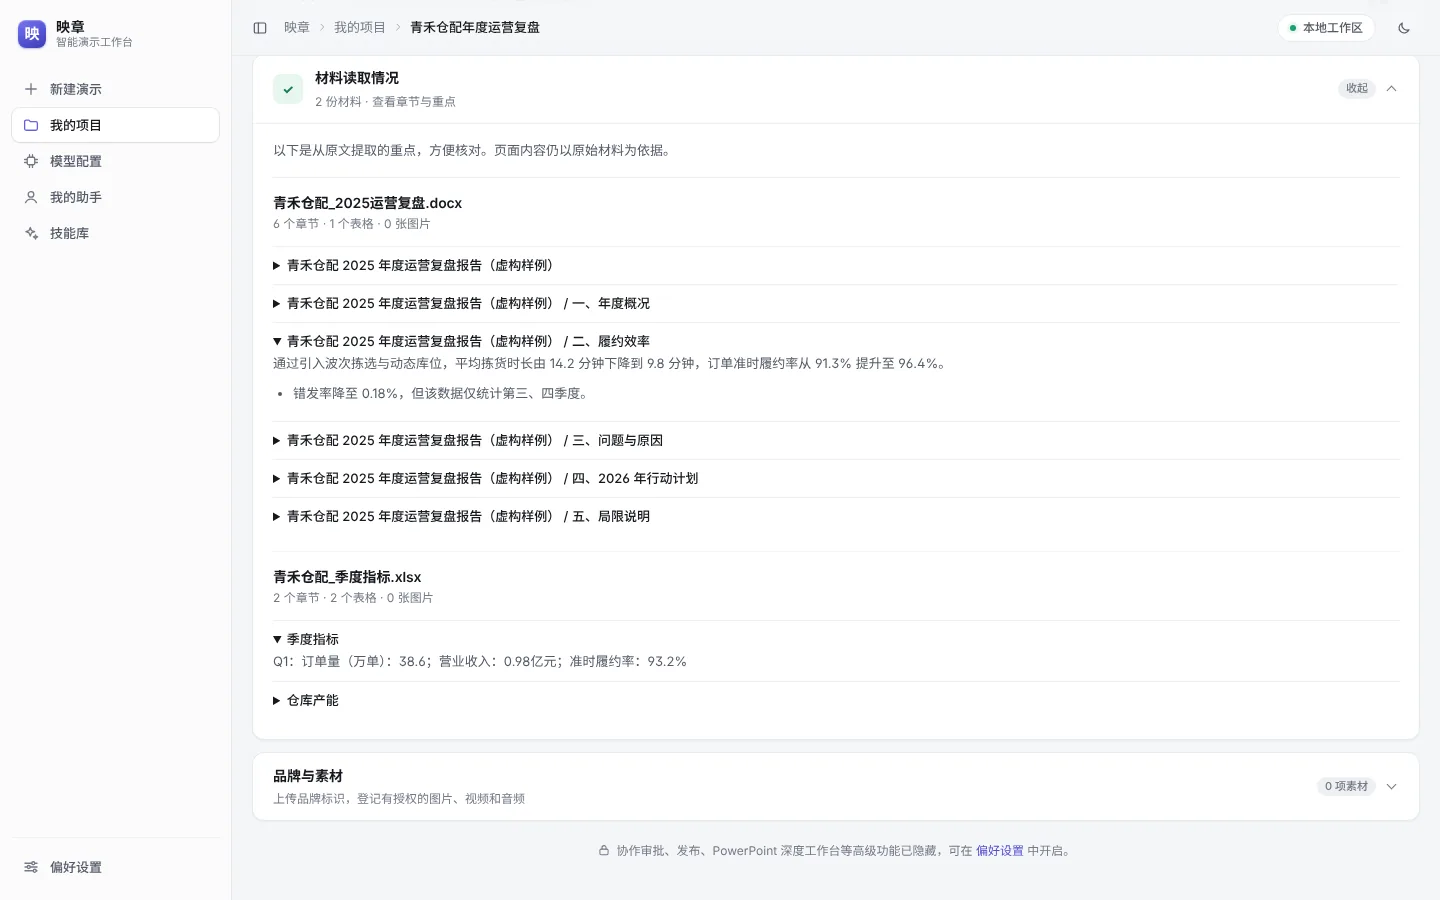
核对材料读得对不对
“材料读取情况”里能逐章展开,看每一章被读成了什么、哪些表格和数字进了索引。这次 Word 解析出 6 章 1 张表,Excel 解析出 2 张表。
确认大纲:看系统拦下了什么
如果选择分步确认,页面列表就是大纲。为了演示拦截,我故意让模拟接口在第 9 页写了一句材料里没有的“预计 2026 年订单量将突破 230 万单”。系统记录了“出现事实白名单之外的数字”,这句话没有进入页面;横幅里显示“10 页中 8 页直接采用 · 2 页已修正 · 0 页使用内置规划”。
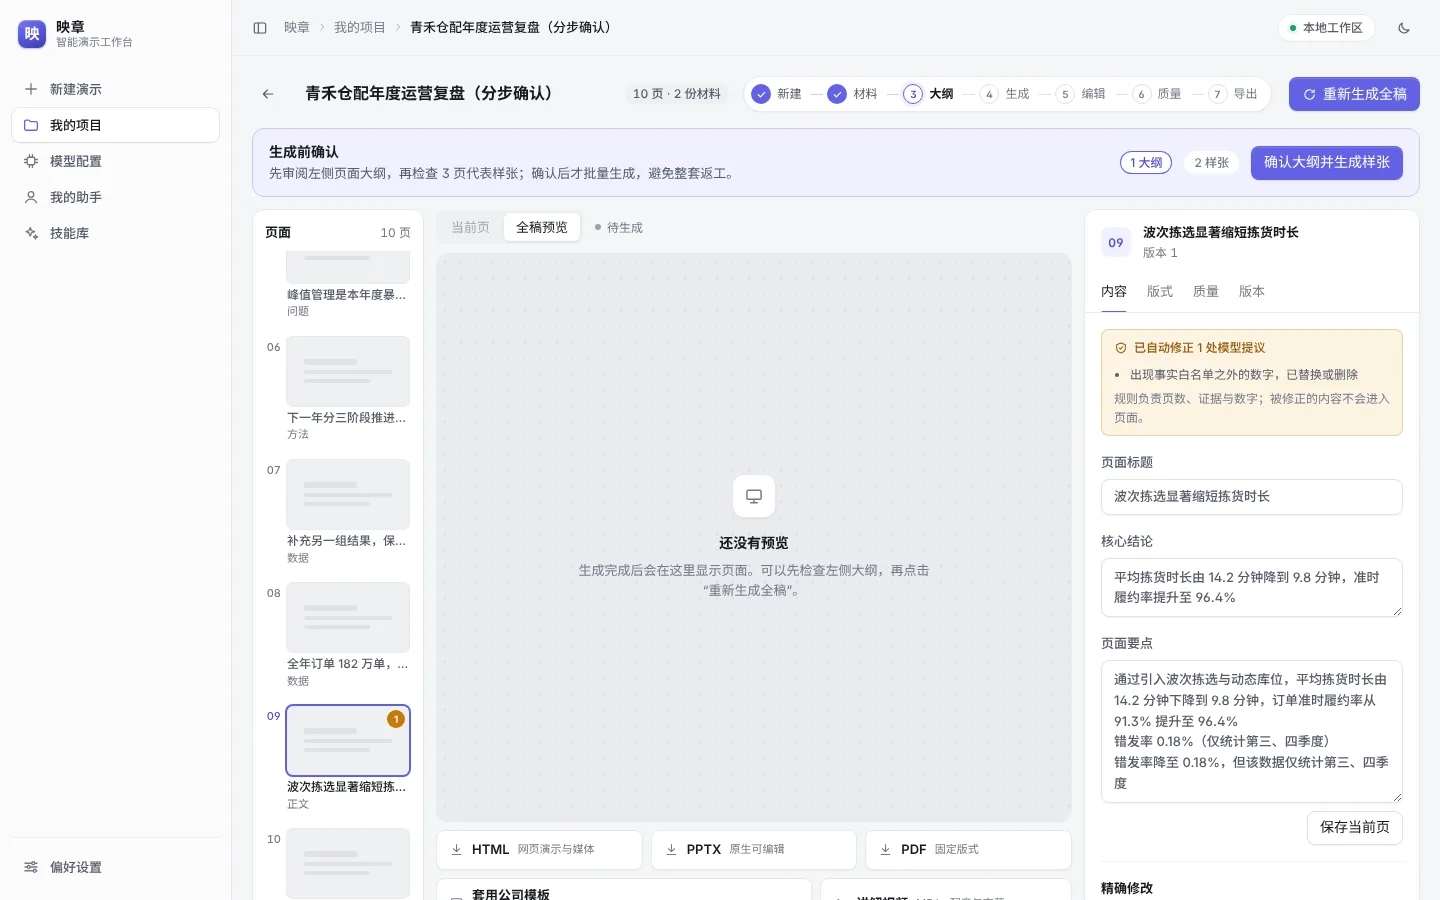
确认大纲后先生成 3 页代表样张,确认样张再生成全稿。这两道门在 MCP 里也生效:Agent 调用时会收到同样的“请先确认大纲与代表样张”,不能替用户跳过。
挑版式
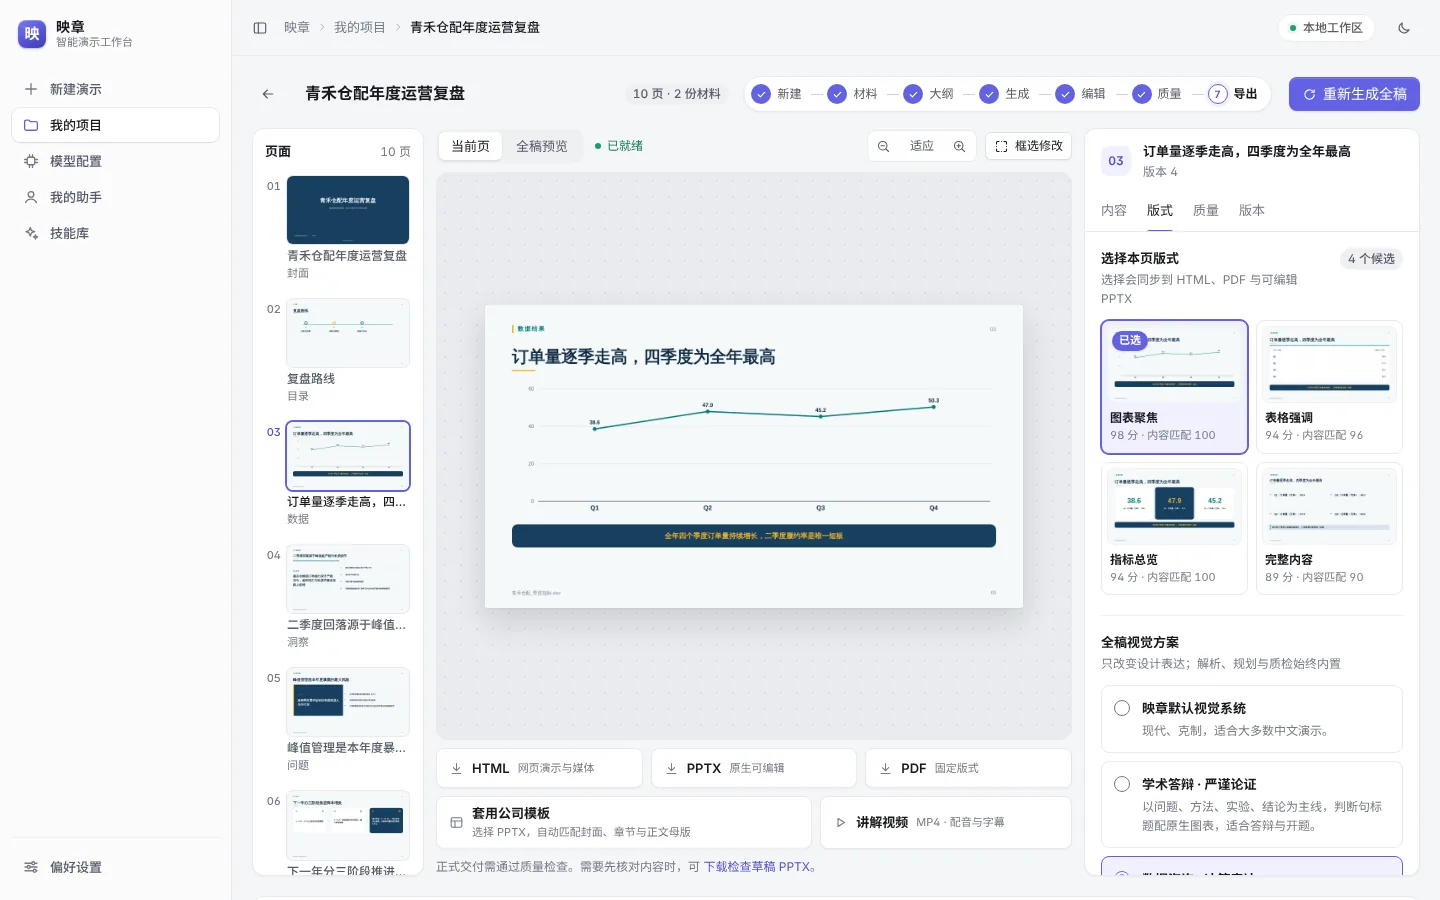
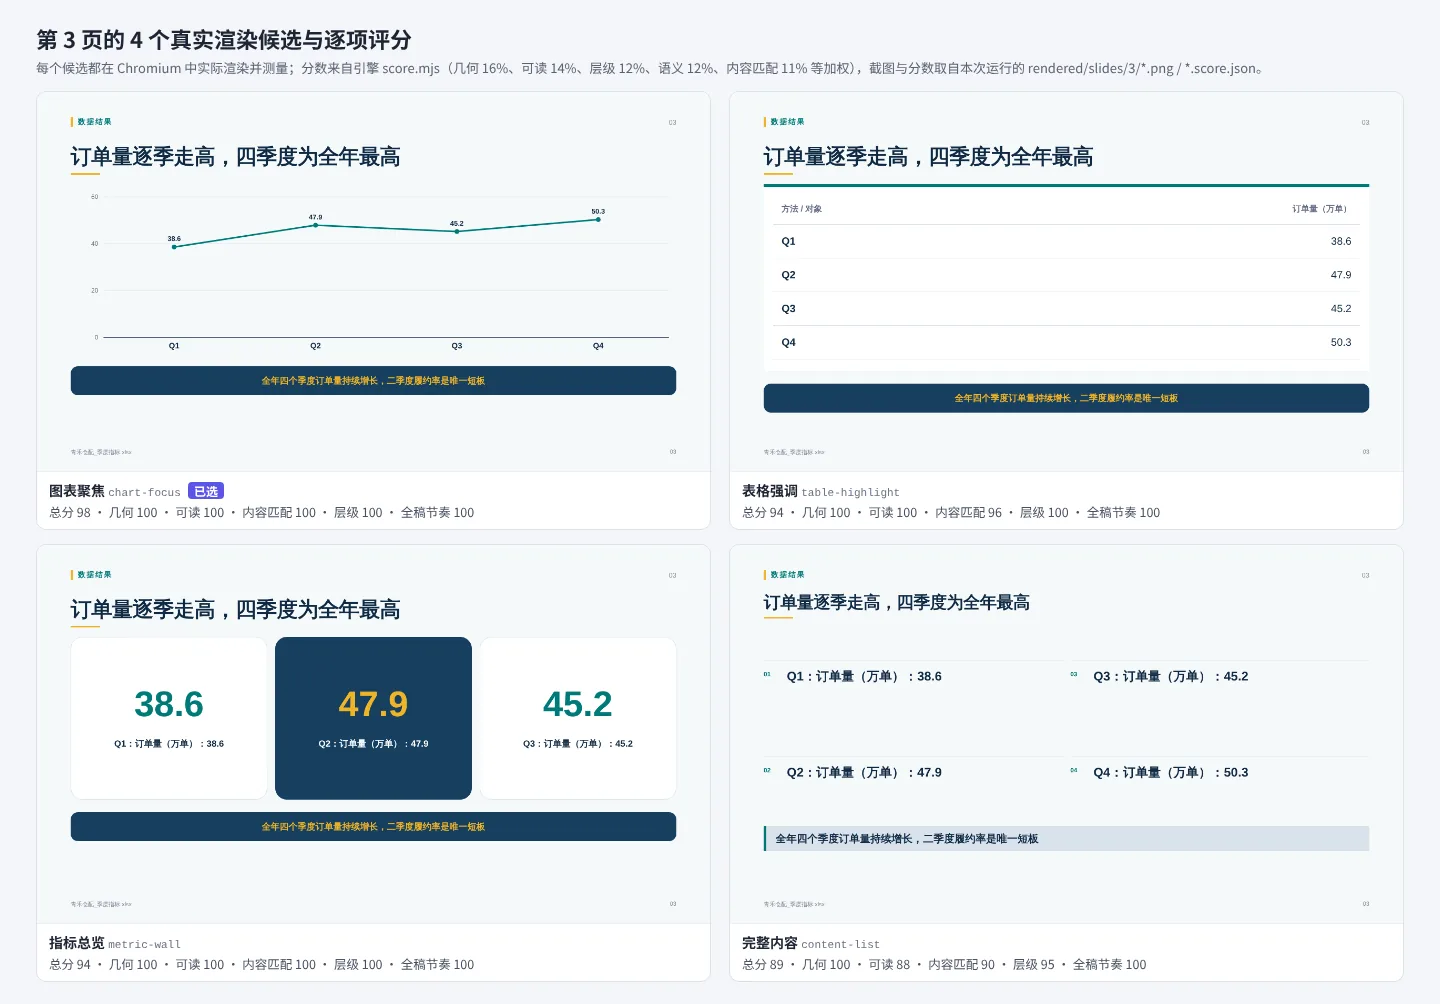
工作台是三栏:左边页面列表,中间画布,右边检查器(内容 / 版式 / 质量 / 版本)。第 3 页“订单量逐季走高”有 4 个候选:图表聚焦 98 分(已选)、表格强调 94、指标总览 94、完整内容 89。选中的版式会同步到 HTML、PDF 和 PPTX,后台重跑不会覆盖。
框选修改
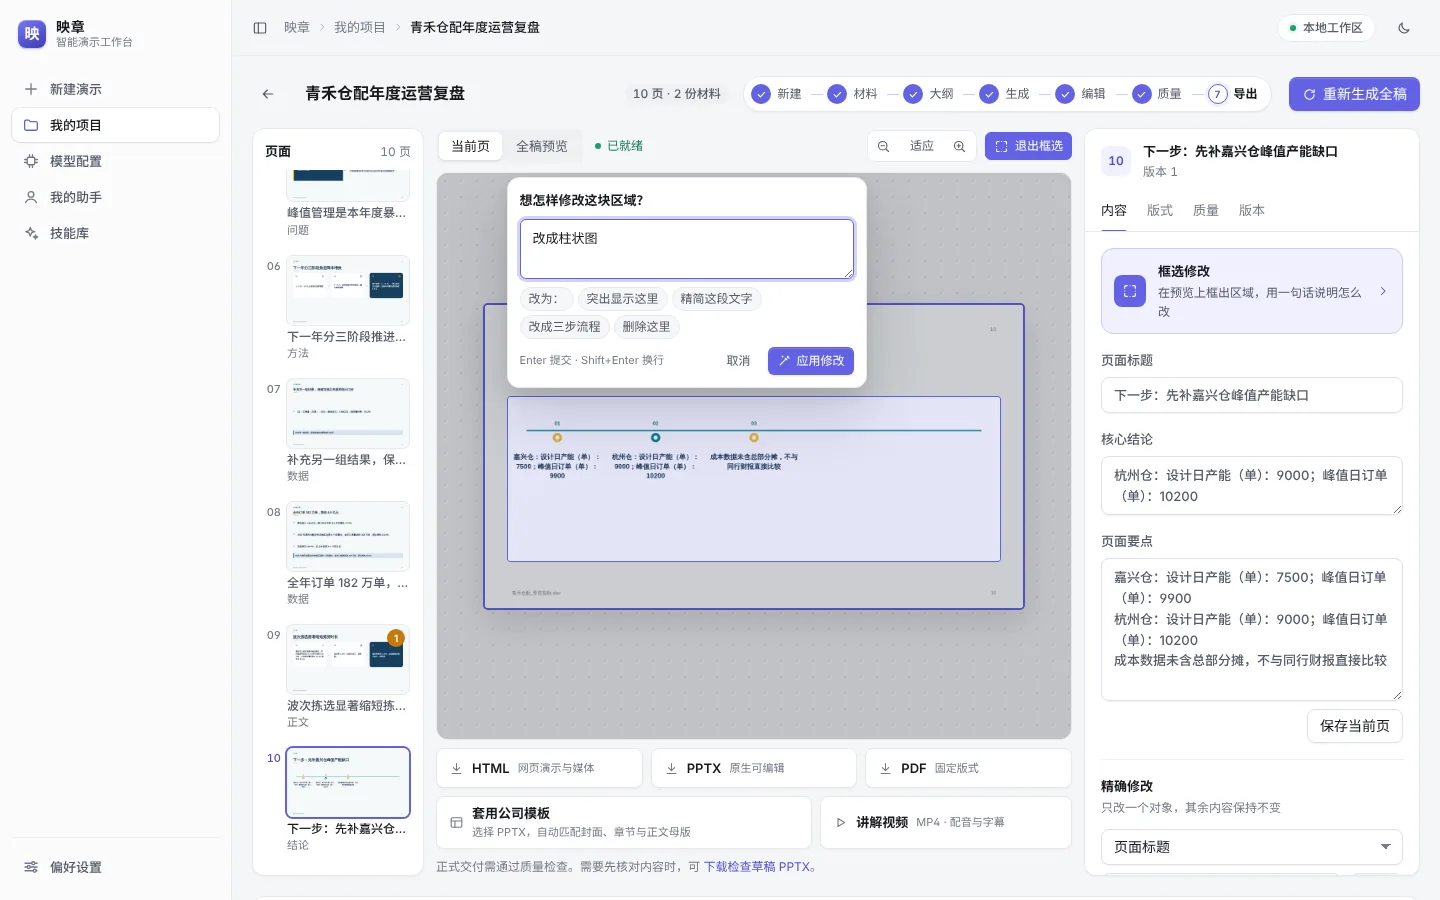
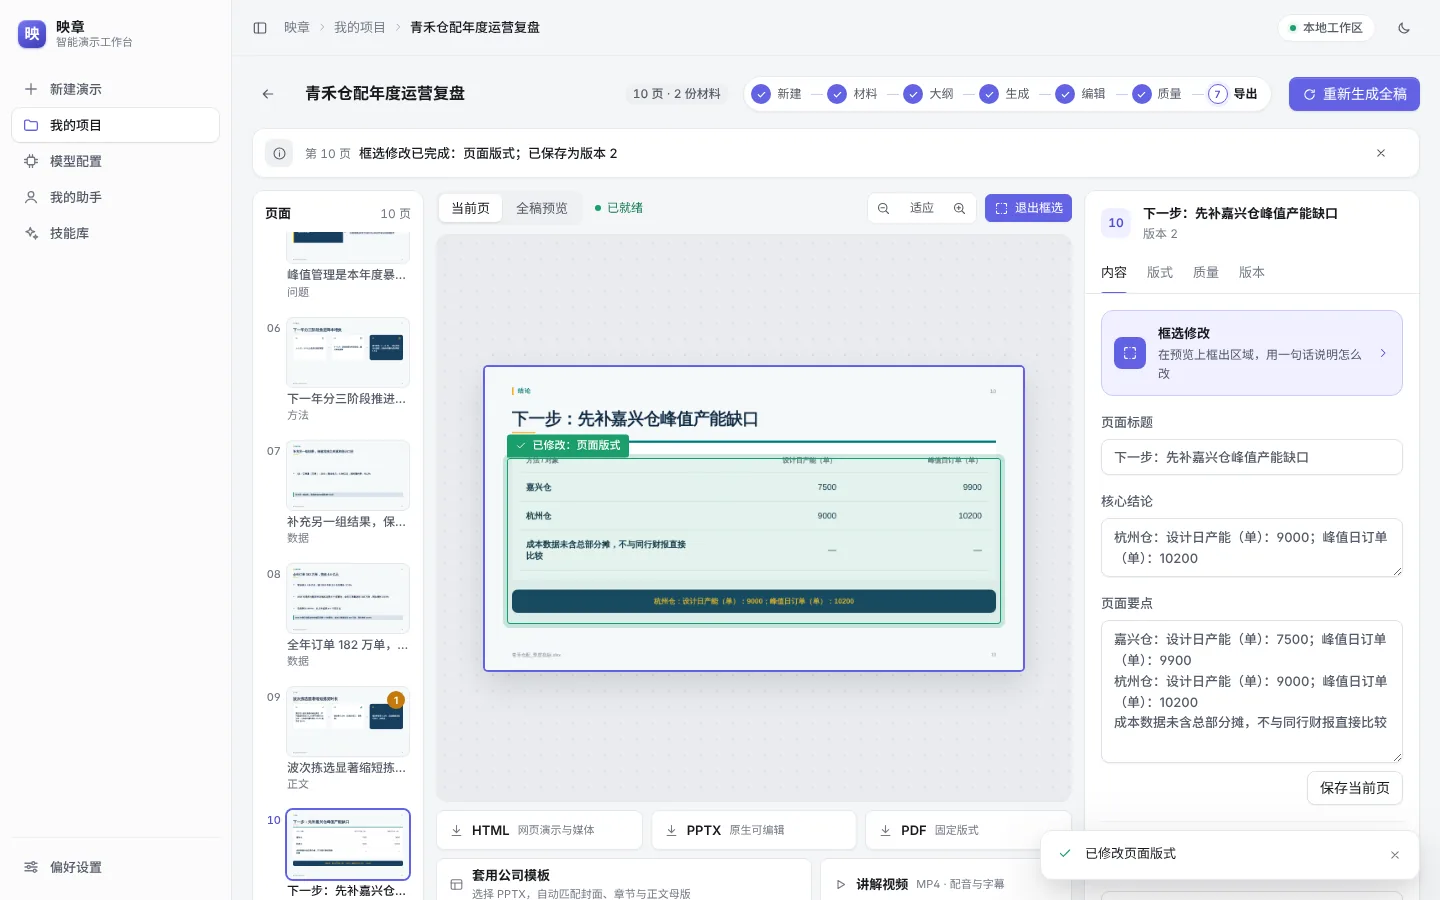
在画布上拖一个框,写一句要求,只改框里的对象。我在第 10 页框住产能要点,写“改成柱状图”,结果提示“已修改:页面版式,已保存为版本 2”——但生成的是表格,不是柱状图。原因是这组数据里混了一行没有数值的限制说明(“成本数据未含总部分摊,不与同行财报直接比较”),图表选择器判定它不适合画图。这正是设计意图:用户的要求是提议,数据形态是底线。
过质量门禁
初稿得分 88/A。我又手动把第 3 页标题改成“四季度达 50.3 万单”,因为“50.3 万”和原文的口径(表头“订单量(万单)”加单元格 50.3)对不上,质量立刻被拦成 69/C;改回去以后 89/A,正式导出放行。没通过门禁时,只能导出“检查草稿 PPTX”。
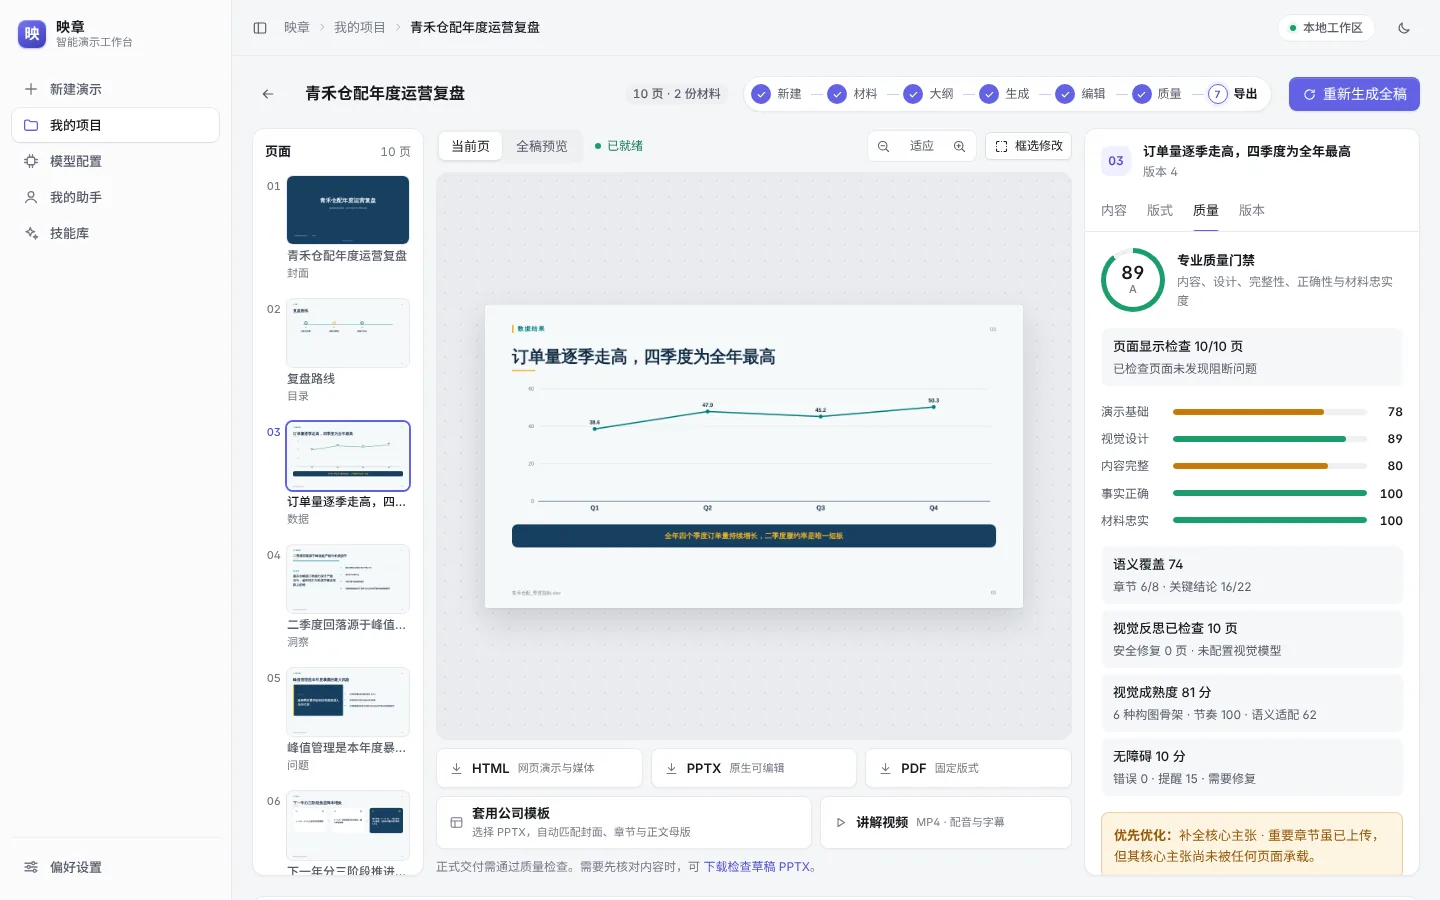
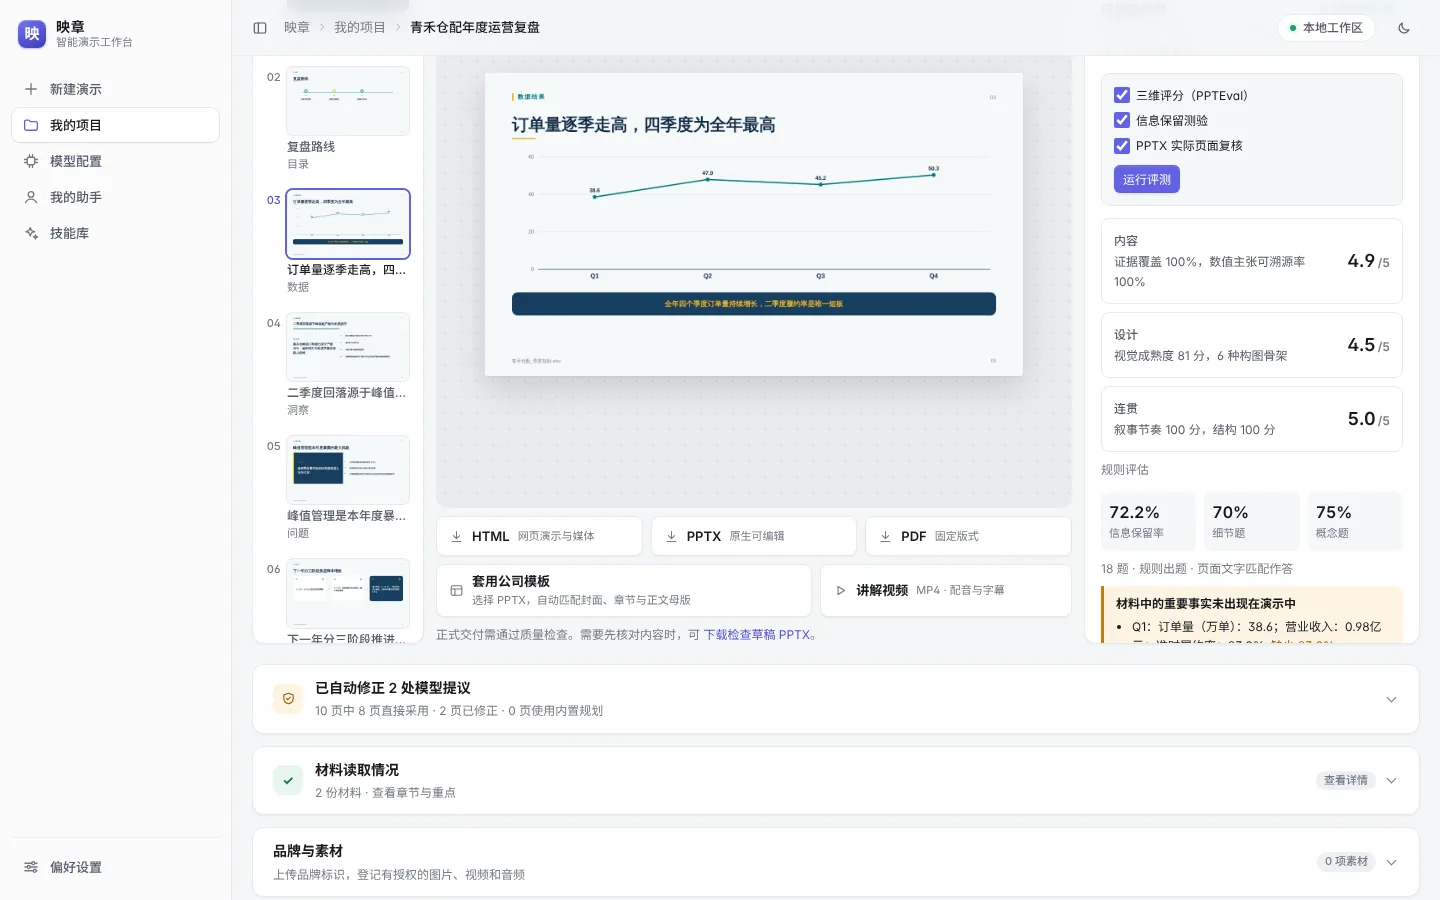
“研究级评测”给出 PPTEval 式三维分:内容 4.9、设计 4.5、连贯 5.0;信息保留测验从材料里出了 18 道题,只凭页面文字作答,保留率 72.2%,并列出了没进入演示的事实(比如“Q3 准时履约率 95.8%”),方便决定要不要补一页。
导出
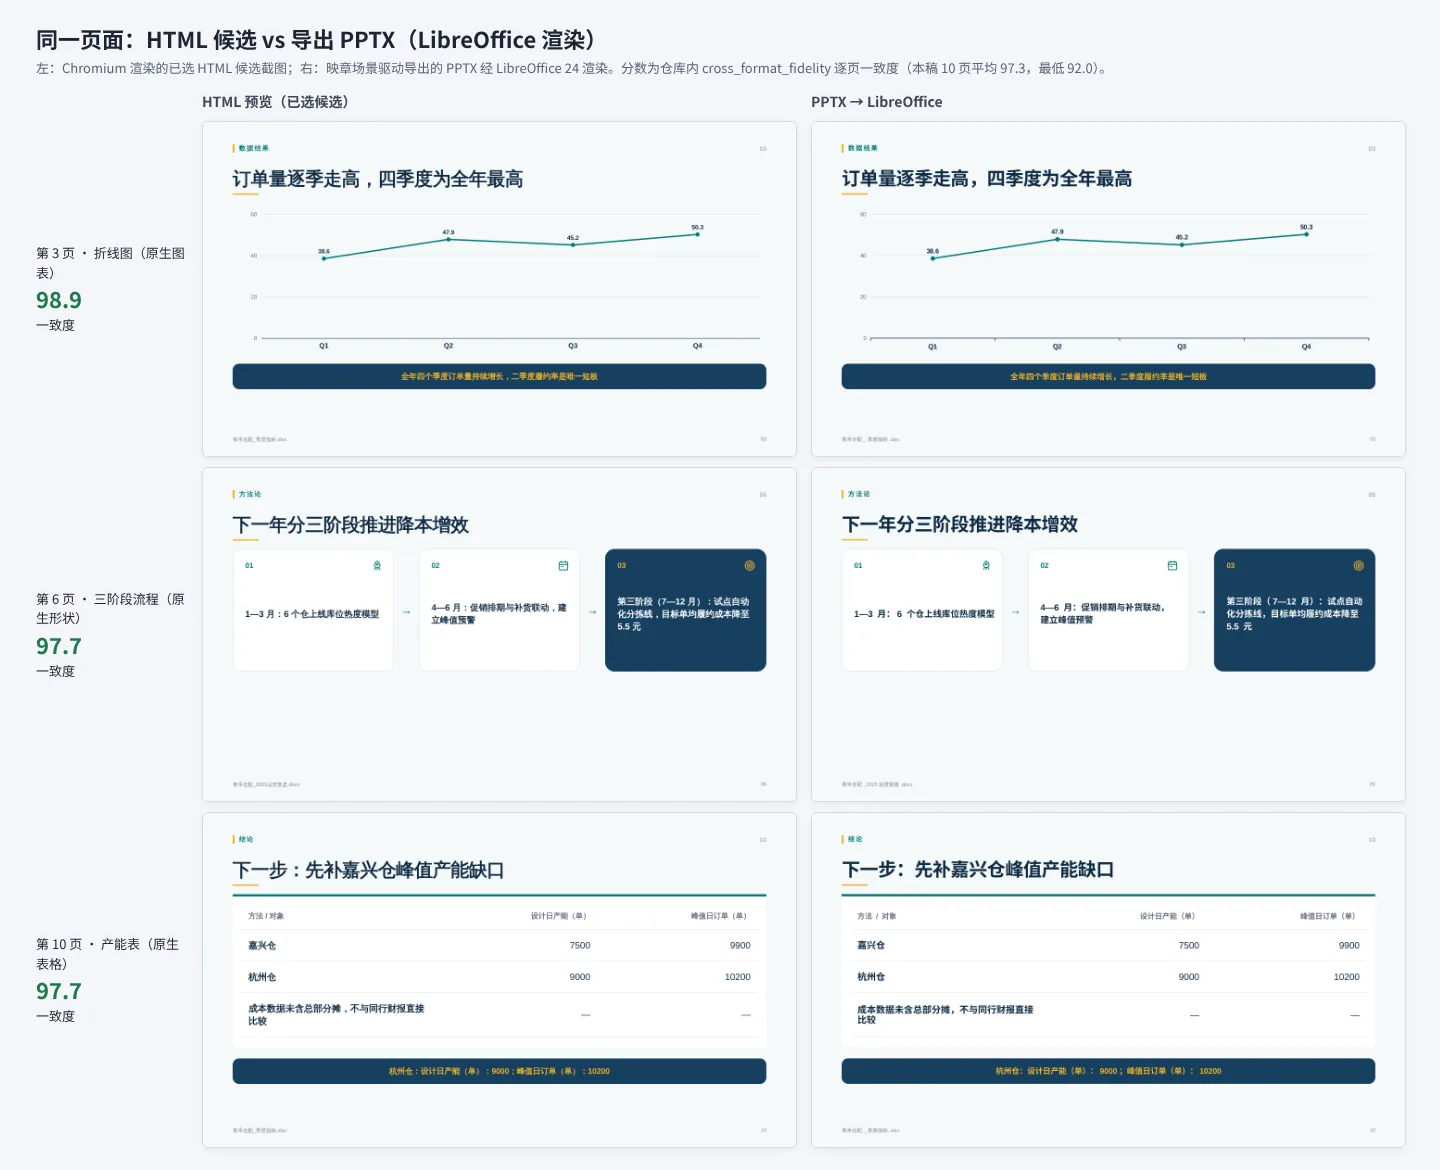
最后导出 PPTX(65 KB)、HTML、PDF(10 页)和讲解视频。把 PPTX 用 LibreOffice 渲染出来和 HTML 候选逐页比对,这份 10 页演示平均一致度 97.3,最低 92.0。
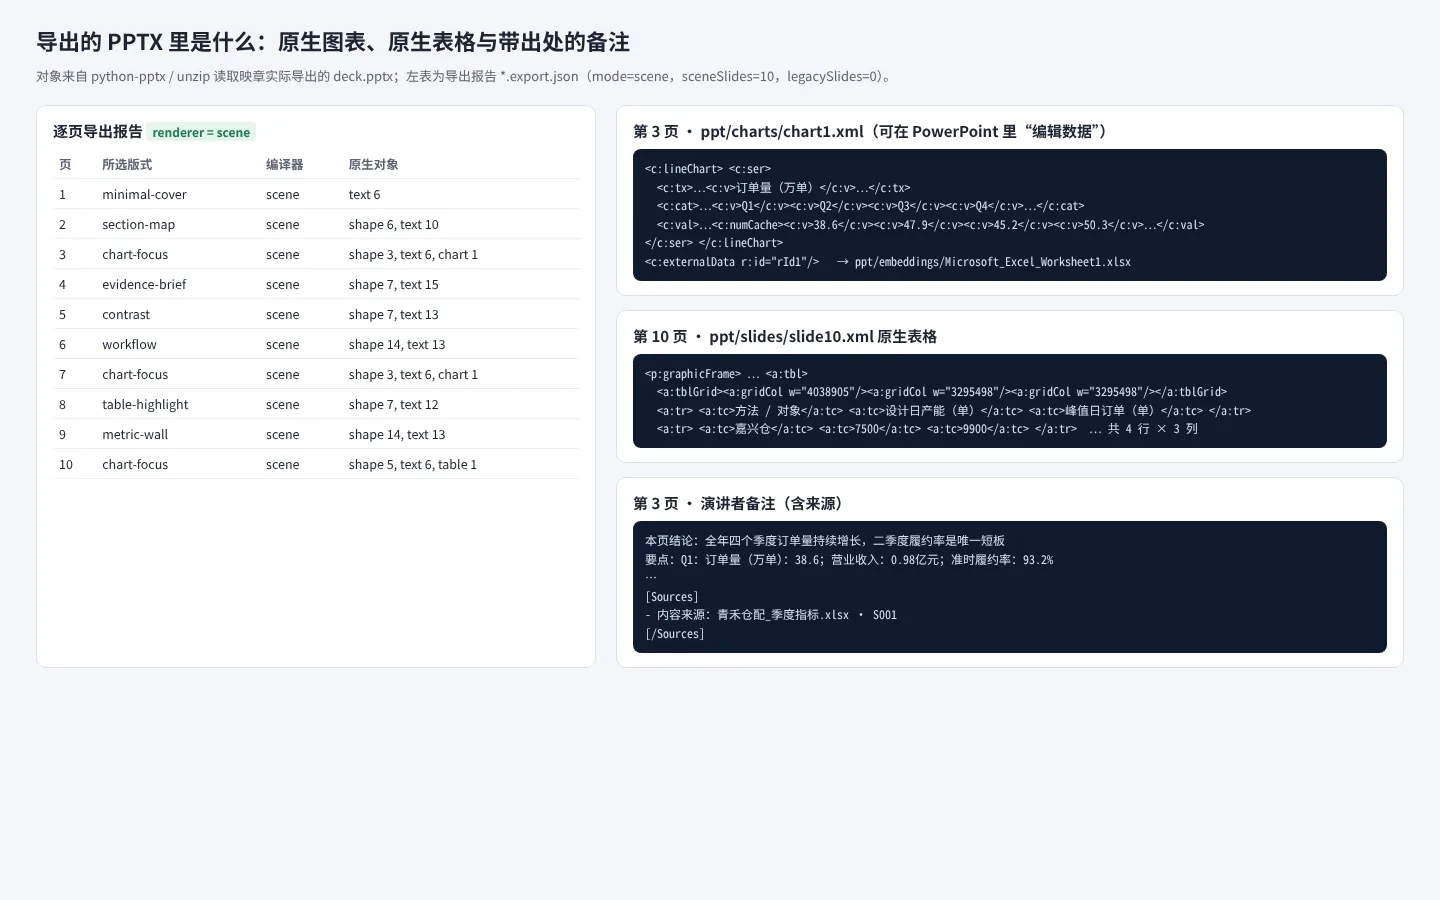
解开 PPTX 能看到:10 页全部走场景导出;第 3、7 页是原生折线图,内嵌 Excel 数据表,在 PowerPoint 里可以直接改数据;第 10 页是原生表格;每页都有演讲备注,末尾附 [Sources] 内容来源:青禾仓配_季度指标.xlsx · S001。
四、整体架构
    flowchart TD
  A["材料导入"] -->|"解析、切分、来源登记"| B["证据索引<br/>BM25 + 可选向量"]
  B -->|"受众 / 目标 / 叙事 / 页面契约"| C["演示计划<br/>策略记忆 → 分批写页 → 一致性复核"]
  C -->|"提议校验:页序、证据、数字白名单"| D["候选渲染<br/>每页多版式 · Chromium 实测"]
  D -->|"几何 / 可读 / 层级 / 语义评分"| E["选版 · 视觉反思 · 定向修复"]
  E --> F["质量门禁"]
  F --> G["HTML · PDF · 原生 PPTX · 讲解视频"]
1 | React 创作工作台(apps/web) |
五、每一块是怎么做的
材料解析:提取到文字不等于读懂了文件
入口是 documents/parser.py,各格式分开处理:
- PDF 用 PyMuPDF 读文字层和坐标,按章节编号、字号和标题关键词切分;表格先用
find_tables()恢复单元格,失败再按对齐的数字行规则恢复;位图按距离匹配“图 3-1 / 表 4-2”这类图注;目录页和页码被过滤掉; - 扫描件和图片可以接本机 Tesseract(中英文,每份 PDF 最多识别 20 页),结果标记为待核对,也不会被当成可靠的表格数据;
- Word 按原文顺序读取,正文、表格和图片不再分离,保留标题路径、表格归属和图注;
- Excel / CSV 逐表读取,保留百分比、日期和空白的含义,每张表最多 10000 行,公式没有缓存值时会提示;
- PPTX 用 python-pptx 读取。
每个章节还会打上语义角色(背景 / 方法 / 实验 / 结论……)和重要度权重(有指标 +0.22,方法和数据类 +0.18),结果存为 source-model.json,同时登记来源编号 S001、S002……
这一层最大的教训是:提取到文字,不等于理解了文件。 Word 里的表格如果离开所在章节,数字就失去了上下文;Excel 的百分比若被当作小数,比较口径就会改变;长文只截取开头,真正重要的结论和局限可能永远进不了页面。比如源表里“新方案 / 准确率 89.6% / 耗时空白”,现在会保留成“新方案:准确率 89.6%;耗时:未提供”——缺失值不会变成零,也不会为了画柱状图把百分比和秒放在同一个坐标轴上。
检索:长文不能只读开头
intelligence/bm25.py 是纯 Python 的 Okapi BM25(k1 = 1.5,b = 0.75)。中文按字符二元组切词,数字连同小数点和百分号作为一个整词,所以 89.6% 只会命中同一个数值。配了向量模型时,retrieval.py 用 RRF(k = 60)融合 BM25 和向量两路排名,再叠加结构加分:重要标题 +4、含指标 +2、首尾段落 +2。拼上下文时先保证每份材料至少有一段进来,再分配剩余预算。
证据约束:模型写的数字必须在白名单里
这是映章最核心的一块,分三道防线:
- 白名单进提示词:规划时每页带固定的来源引用和证据绑定(F0001……),以及本批的事实白名单,提示词明确要求“不得增删页面、改变位置、发明数字”;
- 逐条校验模型提议(
intelligence/proposal_validator.py):第 1 页必须是封面、最后一页负责收束;页面角色必须在该演示类型允许的范围内;不存在的证据编号直接删除;抽出的数字必须在白名单里;标题重复或近似重复(相似度 ≥ 0.82)会被替换;标题不超过 44 字、结论不超过 120 字。能修的修,修不了或问题太多的整页回退到内置规划,每条决定都记录下来,界面上可见; - 对象—指标—数值三元关系校验(
content_claims.py):只查“数字在不在原文里”是不够的。早期复现过一个问题:把“方案 A 准确率 71.2%、方案 B 89.6%”对调,两个数字都在原文里,照样通过。现在会校验“哪个对象的哪个指标是多少”,对调会被判为metric-binding-mismatch。
精确出处、讲解要点和过渡语进入演讲备注,观众看到的页脚保持干净。开放网络素材也不是搜到就用:图片要登记作者、许可、来源链接和替代文本,许可不明的不能进入最终页面。
规划:15 类演示契约 + 小模型分段协作
每类演示有一组“页面契约”(intelligence/contract_library.py),每条写明页面角色、本页唯一的沟通任务、关键词和目标。比如学术答辩按“背景—方法—实验”分阶段,商业计划书有 16 条契约。
模型调用分三段:先用一次调用建立策略记忆(受众、沟通目标、中心命题、3~5 个章节目标);再分批写页,每批带上一批的工作记忆和已用标题;最后做一次一致性复核,只允许改标题和结论,不能新增数字。模型失败时由内置规划补位。
分批的大小由模型能力决定。我自己主要用的是硅基流动上的 Qwen3-8B、GLM-4-9B 这类免费小模型,所以 small_model.py 会从模型 ID 里识别参数量,自动选择策略:
| 策略 | 条件 | 每批页数 | 上下文 | 输出上限 | 温度 |
|---|---|---|---|---|---|
| rules-only | 没配模型 | 纯规则 | – | – | – |
| tiny | ≤ 10B | 3 | 7600 | 2600 | 0.14 |
| compact | ≤ 30B 或识别不出 | 4 | 13000 | 3600 | 0.17 |
| capable | > 30B | 7 | 22000 | 5200 | 0.2 |
只有 capable 档的模型才被允许建议视觉类型。这张表背后是开发中的一次方向调整,下文第六节会讲。
多候选渲染与评分:生成代码不等于画面成立
演示引擎(Node)为每页按版式规划顺序、角色默认版式和参考稿学到的版式生成若干候选,再加一个兜底的“完整内容”,逐个写成 HTML、在 Chromium 里截图并测量,然后打分:
| 维度 | 权重 | 维度 | 权重 |
|---|---|---|---|
| 几何 | 16% | 留白 | 9% |
| 可读 | 14% | 对齐 | 8% |
| 层级 | 12% | 视觉证据 | 7% |
| 语义 | 12% | 规划吻合 | 6% |
| 内容匹配 | 11% | 风格 / 全稿节奏 | 3% / 2% |
全稿节奏分用来防止整套都是同一种版式:deckRhythm = max(48, 100 − 同版式重复×16 − 同家族重复×7 − 与上一页同家族×18)。早期出现过“候选名字不同、画面实际一样”的伪多样性,后来才引入版式家族和节奏惩罚。
候选要成为“安全候选”,几何 ≥ 80、可读 ≥ 78、内容匹配 ≥ 62,且没有溢出、裁切、缺图、缺内容。选择的优先级是:用户锁定的选择 > 规划推荐且安全 > 最高分的安全候选 > 兜底。
视觉反思与质量门禁
visual_critic.py 检查溢出、字太小、层级弱、失衡、重复、低对比度、难看的换行和语义不匹配;配了视觉模型就交给它评审,否则用确定性规则。修复是有边界的,只改出问题的地方,不碰用户已确认的选择。
validation/quality.py 有约 40 个检查码,比如文字密度、占位标题、重复内容、无依据的指标、指标绑定不一致、缺证据绑定、事实页用了生图、缺结论、版式单调。专业审计分五维:演示基础、视觉设计、内容完整、事实正确、材料忠实。正式导出前必须通过。
任务系统:长流程必须能取消、恢复和追踪
生成整套演示是长任务。jobs/ 把任务存储(SQLite 完整快照)、执行器(asyncio)和事件总线拆成独立契约。默认同时跑 2 个任务、排队上限 6,单任务内同时渲染 2 页。
工作流节点(workflows/bounded.py)都声明 Pydantic 输入输出、基于规范化输入的 SHA-256 幂等键、最大重试次数、可重试异常白名单和产物路径。整稿流程是 source_ready → evidence_gate → render_candidates → visual_gate → targeted_repair → assemble → delivery_gate,单页失败只影响那一页。“恢复任务”不是重新猜一遍模型当时在做什么,而是复用已完成且仍然有效的节点。
前端先读快照、再订阅 SSE 事件流,首帧带完整快照,每 15 秒一次心跳,断线自动退回轮询。页面、对象和画布写入都带修订号,拒绝过期写入。
框选修改:不调用模型
RegionEditLayer.tsx 把用户拖出的矩形换算到 1280×720 的场景坐标,和这个候选的 scene.json 里每个节点的包围盒求交,定位到标题、结论、要点或主视觉对象。指令用规则解析(“三步 / 时间线 / 流程 / 架构 / 柱状 / 表格 / 对比……”映射到对应版式),这一步不调用模型,所以又快又可预测。
场景驱动导出:先量,再画
v0.1 时最顽固的问题是:网页预览很好看,导出的 PPTX 却走样。 原因很直接,旧导出器按版式手写坐标,HTML 和 PPTX 实际上是两套各自维护的排版。
v0.2 换了思路:每个候选在 Chromium 里渲染时,额外记录一层“导出场景”——背景、边框、圆角、阴影、渐变、带样式的文字段、图片、表格、图表模型和矢量图标,按绘制顺序排列,连 CSS 伪元素也先实体化再测量。导出时按 1280 px = 13.333 in 把这层场景编译成 PowerPoint 原生文本框、形状、表格和图表。
    flowchart LR
  A["HTML 候选"] -->|"Chromium 渲染"| B["导出场景<br/>实测几何"]
  B -->|"校验文字覆盖、去重、图片定位"| C{"可用?"}
  C -->|"是"| D["原生对象编译"]
  C -->|"否"| E["该页回退旧编译器<br/>原因写入报告"]
  D --> F["可编辑 PPTX"]
  E --> F
回退是逐页的:场景缺失或渲染指纹过期就现场重测;文字覆盖或图片定位校验失败,只有那一页退回旧编译器,原因写进 *.export.json。四类基准(学术、商业、数据、产品)的平均一致度从 81.6–86.9 提升到 98.7–99.5,这个数字可以用仓库里的脚本复现。
每次导出都是独立的版本化文件,记录 SHA-256 和内容指纹;页面改过之后,旧导出不能再下载。还修过一个只在真实 PowerPoint 里才暴露的问题:Python 标准库改写幻灯片 XML 时会把 p14、mc 这些命名空间前缀改名,而 mc:Ignorable="p14" 是按前缀名引用的,前缀一改就对不上,PowerPoint 打开时提示修复。现在改用保留原前缀的 lxml,并加了回归测试。
8 类原生图表:按数据形态确定性地选
charts.mjs 不让模型决定图表类型,而是按数据形态选:单序列的增量数据用瀑布图;份额加起来是 100 用环形图;季度、年份这类有序标签用折线图;其余类别用柱状图,标签太长换成条形图;两个序列两种单位,有序用柱线组合图、标签多用散点图。HTML 端用 SVG 画,PPTX 端用同一套绘图区布局生成原生图表,所以两边长得一样。配色来自视觉技能的 tokens.json,另有 44 个自绘矢量图标。
视觉技能
内置 9 套视觉技能:学术答辩、数据咨询、编辑叙事、金融研报、政务汇报等。每套由 SKILL.md、skill.json 和 tokens.json 组成,tokens 里声明网格、页边距、栏间距、字号阶梯、主色、密度偏好和装饰母题。技能只改变设计表达,解析、规划和质检始终是内置流程;第三方技能可以通过链接安装,但默认不执行脚本。
讲解视频与 Agent 集成
讲解视频:讲稿依次取页面的讲述意图、演讲要点,都没有就由标题、结论和要点确定性生成;配音调用语音合成接口,没配就按文字长度生成静音片段;ffmpeg 为每页生成参数一致的 H.264/AAC 片段再无损拼接,同时生成 SRT 字幕。这次实测得到一个 1920×1080、240 秒的 MP4。
MCP:integrations/mcp/yingzhang_mcp.py 是一个不依赖 MCP SDK 的 stdio JSON-RPC 服务器,提供 10 个工具(列出项目、创建项目、上传材料、规划大纲、生成全稿、查任务、列页面、改页面、评测、导出)。门禁仍由服务端执行,Agent 收到“请先确认大纲与代表样张”就必须停下来问用户。配套的 Agent Skill 教 Claude Code、Codex 按“启动 → 上传 → 确认大纲 → 确认样张 → 生成 → 复核 → 导出”的顺序工作。
部署
- Windows:双击
启动映章.exe。它只是一个 38 行 C# 写的启动器,真正的工作在scripts/start-local.ps1:用 winget 准备 uv、Python 3.12 和 Node LTS,安装锁定的依赖和 Playwright Chromium,构建前端,后台启动服务,打开http://127.0.0.1:8000; - Docker:多阶段构建,内置 Chromium、思源黑体和 ffmpeg,LibreOffice 和 Tesseract 通过构建参数开启;只绑 127.0.0.1,状态都在一个卷里;
- 默认是本地单用户、免登录;服务只支持单进程,检测到多 worker 会拒绝启动。
六、开发中的几个关键转折
1. 从“让模型自由发挥”到“规则驱动的演示编译器”。 我主要用 30B 以内、尤其是 10B 以内的免费小模型。早期测出来的 25 页答辩里,泛化卡片很多,借来的图也错位。讨论后定下的原则是:规则决定必须做什么、绝不能做什么,模型决定在允许范围内怎样表达得更好。 后来又追问“边界一定要这么硬吗”,方案调整成“硬底线 + 小模型分段协作”:先建全局策略记忆,每 3~4 页规划一次,最后跨段复核——也就是第五节那张策略表和提议校验器的来历。用一句“根据材料制作本科毕业答辩 PPT,内容详细一点”测试,结果正好 12 页,21 个数字声明全部有依据。
2. 公网测试一路踩坑,最后回到本地。 曾经想让朋友在线试用:20 页长任务超过 Cloudflare 等待时间返回 524,前端还把 HTML 错误页原样显示了出来,于是改成后台异步任务、进度持久化,错误页转成中文提示;之后 Quick Tunnel 又出现 530,隧道换协议、换 SSH 通道都不稳定;Cloudflare Workers 和容器部署需要付费方案。最后决定去掉登录,回到本地单用户:项目发到 GitHub,每个人在自己电脑上部署自己的。
3. 数据库和并发。 并发渲染时进度写入引发过 SQLite 锁冲突;发布启动器后,旧库里有 613 条孤立页面版本和 1691 条孤立候选稿,完整性检查拒绝启动,于是把“先备份再修复”写进了启动脚本;还有一次是规划模型运行期间,技能选择一直占着写事务,12 秒后进度写入失败——修法是不在模型调用期间持有写锁,并让失败的整稿任务可以用原设置重试。
4. 数字校验越做越细。 除了上面提到的指标对调,还修过 1,200 被截成 1、负号丢失、小数被误切、来源编号“S003”被误认成指标、两个不同指标的增幅被拼成一组伪对比。
5. “优化项目,而不是直接修 PPT”。 用一份商业计划书测试时,发现第 2 页的论证逻辑是空的。我的 AI 助手第一反应是直接改那份 PPTX——但我要的是让系统以后能做好这类演示。这才有了商业计划书的 16 条契约,以及跨页表格、合并表头和负数的解析。
6. 参考,但不照搬。 项目早期系统研究过 ai-ppt-generator,吸收了“规划—生成—渲染—评价”的流程思想;v0.2 又对照了 PPT Master、Presenton、PPTAgent、banana-slides、LandPPT 和 dom-to-pptx。几个结论:“测量 DOM 再生成原生对象”是共识方向,dom-to-pptx 和映章思路一致,PPT Master 走 SVG 转 DrawingML;“每页生成一张图”视觉冲击强,但文字和图表无法再编辑,不适合正式交付;证据绑定、提议校验、质量门禁和可复现评测是映章做得比较深的地方。没有照搬的部分同样重要:不把模板数量当成视觉质量,不让模型自由执行外部代码,也不允许一次失败无限重试。
七、版本历程
| 时间 | 版本 | 主要内容 |
|---|---|---|
| 2026-09-04 | 开发期 | 证据图谱、有界工作流节点、多候选渲染、HTML / PDF / PPTX 三格式交付 |
| 2026-09-06 | 开发期 | 材料结构化(Word 原文顺序、PDF 表格恢复、Excel 口径);“判断与证据”版式 |
| 2026-09-13 | v0.1.0 | 首个公开版本;去掉登录回到本地;Windows 启动器 |
| 2026-10-19 | v0.2.0 | 场景驱动 PPTX 导出;8 类原生图表;BM25 + 向量检索;研究级评测;框选修改;讲解视频;MCP 与 Agent Skill;Docker |
八、当前边界与下一步
- 格式兼容:跨格式保真度是在 LibreOffice 上测得的,PowerPoint 和 WPS 的字体替换和换行还需要实机验收,这是下一阶段最优先的事;
- 数字白名单管得偏严:这次运行发现,演示标题里带年份(比如“2025 运营复盘”)而封面页证据里没有这个年份时,封面标题会被换成兜底文案“关键结果”。导航类页面应该放宽;
- 内置规划不够细:Excel 季度表在没有模型时,“季度指标”页只放了第一季度,需要手动补齐;指标总览候选只放得下 3 张卡片,内容匹配分却仍是满分;
- 伪多样性没有完全消除:流程类的两个候选画面几乎一样;
- 无障碍:默认视觉方案还有对比度和字号的提醒项;
- 视觉上限:自动评分能发现确定性问题,但不能取代人对审美、业务表达和现场讲述的判断。
下一阶段会先收集真实使用中哪些页面反复修改、哪些候选被选中、哪些交付失败,再决定投入方向。比起堆叠功能,这些数据更能告诉系统离“专业”还差在哪里。
项目源码、工程架构、开发报告、测试材料和本地启动说明都在 映章 GitHub 仓库。